260922中国AIDC万亿新基建何时休
本轮全球AI数据中心扩张速度在基建史上非常少见,三个关键词:钱多、电紧、分化大。 本次对谈系统梳理了全球AIDC资本开支、算力布局与中美差异,中国政策推动路径, AIDC的六大组成部分与成本结构,以及中国电力优势能否转化为算力优势等核心问题。
课程目录
一、核心概念:什么是AIDC?
1.1 关键术语
- H100当量:算力标准换算单位,把不同芯片(B200、TPU、昇腾910等)统一换算成相当于多少张H100
- 功率容量(GW):数据中心持续消耗电力的速度,30GW相当于30台大型核电机组满负荷运转
- AIDC:2023年后出现的面向AI训练和推理的数据中心,区别于传统IDC(通算中心)
1.2 AIDC的三大关键
以英伟达超节点为例:72张GPU卡,功率120kW,而传统机柜只有6kW左右——高了好几个量级。
AIDC与传统IDC的本质区别在于机柜功率密度,是传统数据中心的10-100倍。因此有三大配套必须同步设计:
- 供电:普通线缆搂不住,需要专门的配电结构和设备
- 冷却:传统风冷带不走,AIDC标配液冷
- 高速互联:72张GPU要频繁交换数据,互联高速公路不能拥堵
核心认知:AIDC已经从单张GPU变成了一个小系统集群。任何一环拖后腿,整个昂贵的算力都发挥不出来。
二、全球AIDC资本开支:需求、供给、预期三者共振
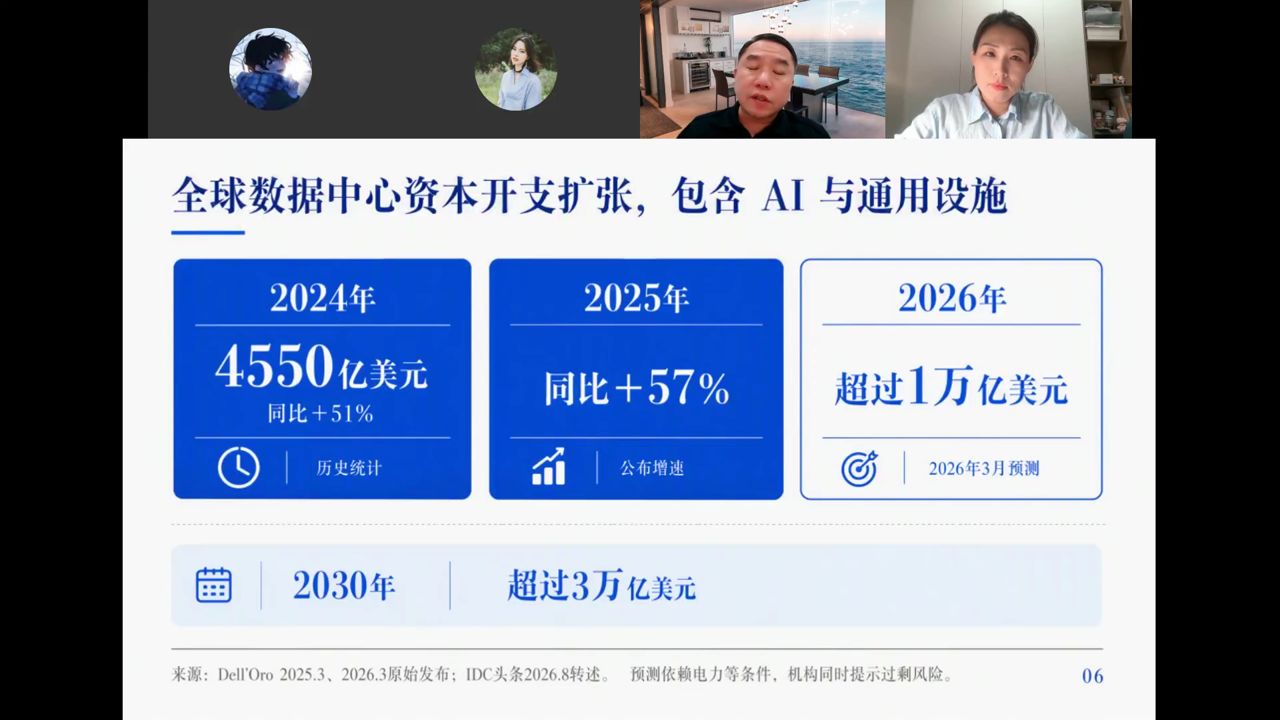
2.1 惊人的资本开支数据
- 2024年:4550亿美元,同比+51%
- 2025年:同比+57%
- 2026年:预计超过1万亿美元
- 2030年:预计超过3万亿美元
2.2 为什么会爆发?三者共振形成正反馈循环
需求端(最底层驱动力):
- 从ChatGPT到Coding再到Agent,应用形态不断演进
- OpenAI、Anthropic的算力增长曲线惊人,ARR同步高增长
- 国内:DeepSeek 7-8个月收回全部投资,Kimi流量快速增长
- 麦肯锡预测:2025-2030年算力需求增长350%,AI负载将超过总负载50%
供给端(严重短缺):
- 需求来得太快、太集中,供给弹性差
- 缺什么?GPU芯片→HBM→光通信→磷化铟→变压器→电网
- 变压器交付周期在海外已达4年,电力并网排队更长
- 系统级约束:计算、存储、通信、供电、散热必须齐头并进
预期端(线性外推):
- 投资者看到需求旺盛、供给短缺,做线性外推
- 股价走在实际采购前面,相当于给整个产业做了"实物期权"
- 股价上涨→厂商更有动力投入CAPEX→形成正反馈
60-70%是确定需求,30-40%是提前布局
大部分是已签约的客户需求(长单锁量),但因为供给短缺,厂商必须提前抢产能、抢电指标、抢土地,这部分形成了冗余的提前布局。
三、算力密度提升远超功耗和建筑增速
3.1 三张图连看
根据86个站点的统计:
- 2023年累计算力:15.7万H100当量
- 2025年:487.7万H100当量
- 2028年预测:超过1000万H100当量
但功耗增长和投运建筑增长,都远低于算力增长。
结论:本轮算力扩张主要不是靠建新站点,而是靠单站点算力密度的大幅提升。一栋楼里容纳的算力明显增加了。
3.2 为什么密度能提升?
- 芯片制程进步:单芯片算力每代增长数倍,黄仁勋说有些是10倍增长
- 先进封装:通过堆叠、新封装方式,单位面积算力密度提升
- 技术改进:单功耗算力增长更快,所以功耗增长赶不上算力增长
四、全球算力布局:中美模式差异
4.1 云厂商是算力建设的主力军
9大云服务厂商2026年合计算力投资预计达8300亿美元,同比增长79%。
4.2 单站点算力 vs 总算力排名
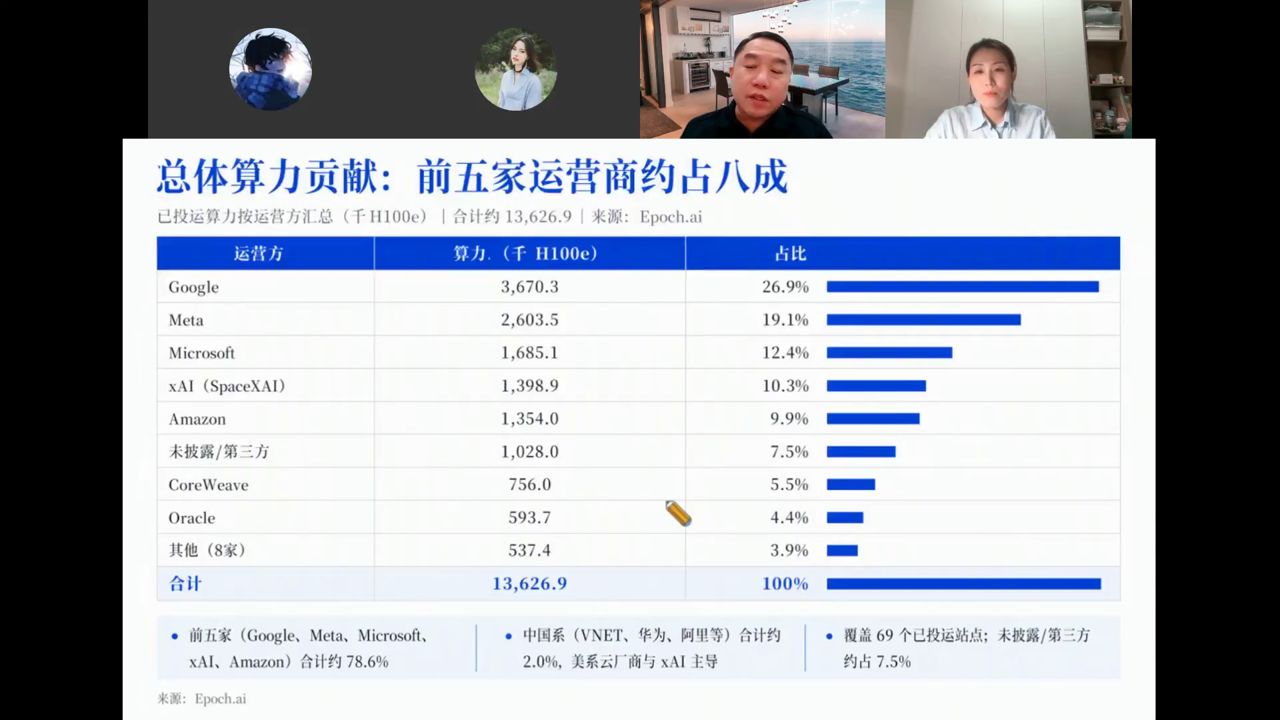
单站点排名:xAI领先(超级站点模式)
总算力排名:Google领先(多站点布局模式)
两种模式的差异:
- xAI:重新拿地、拿到就尽量做大,少数超级巨兽站点
- Google:利用已有site扩容,布局多站点,总量更大
4.3 中国的情况
- 中国公司不在全球单站点TOP20里
- 前86个样本中,能排上号的:字节、华为、阿里
- 字节在总体和单站点上最高,其次华为,再次阿里
- 中国系合计约占全球2.0%
4.4 中美差异的原因
美国:多超级大站点,集中度高
中国:更分散,原因有三:
- 合建模式:地方政府有政绩需求,每个地方都要建,厂商需要资金杠杆和补贴
- 训练西移、推理东移:训练放到西北(便宜电、土地),推理靠近东南沿海用户
- 大城市多:中国大城市数量多,算力中心更靠近用户
4.5 中国智算中心:谁主导建设,谁负责运营
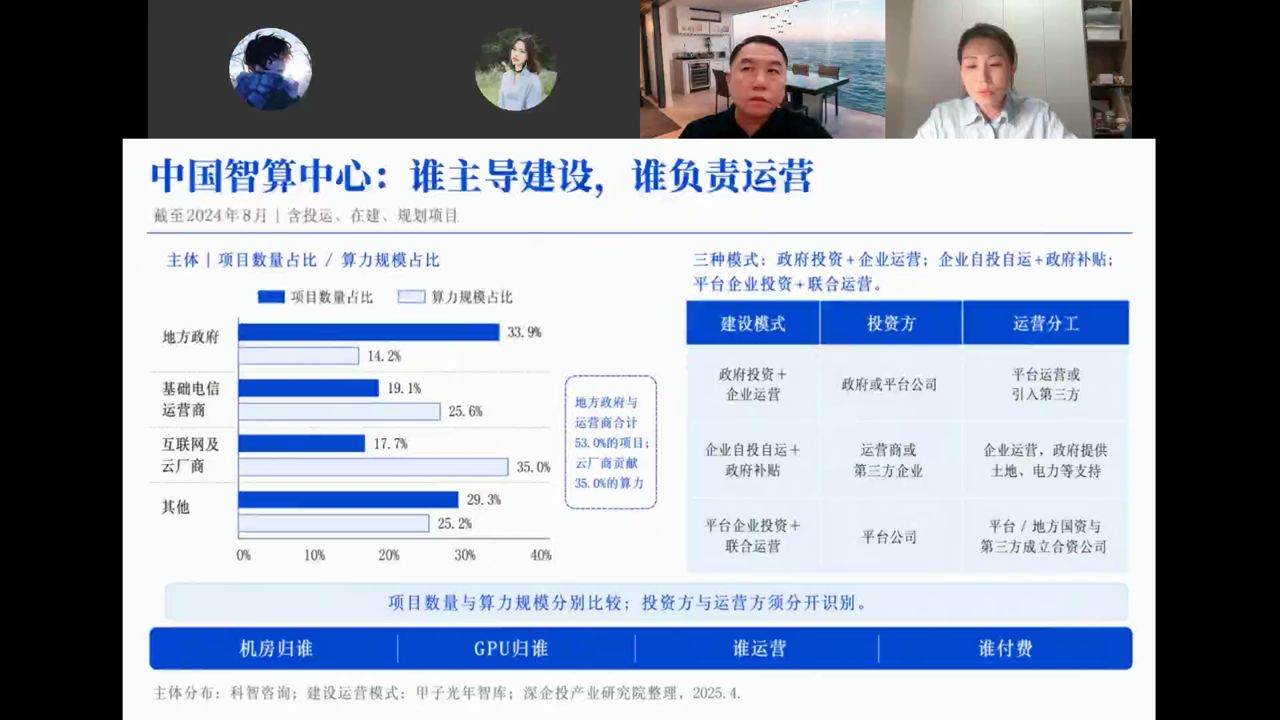
截至2024年8月,含投运、在建、规划项目:
- 地方政府:项目数量占比33.9%最高,但算力规模仅14.2%——项目多但单体小
- 基础电信运营商:项目19.1%,算力25.6%
- 互联网及云厂商:项目17.7%,算力规模35.0%——项目少但单体算力大
三种建设运营模式:① 政府投资+企业运营;② 企业自投自运+政府补贴;③ 平台企业投资+联合运营。地方政府与运营商合计占53%项目,云厂商贡献35%算力。
4.6 中美五年投资体量对比
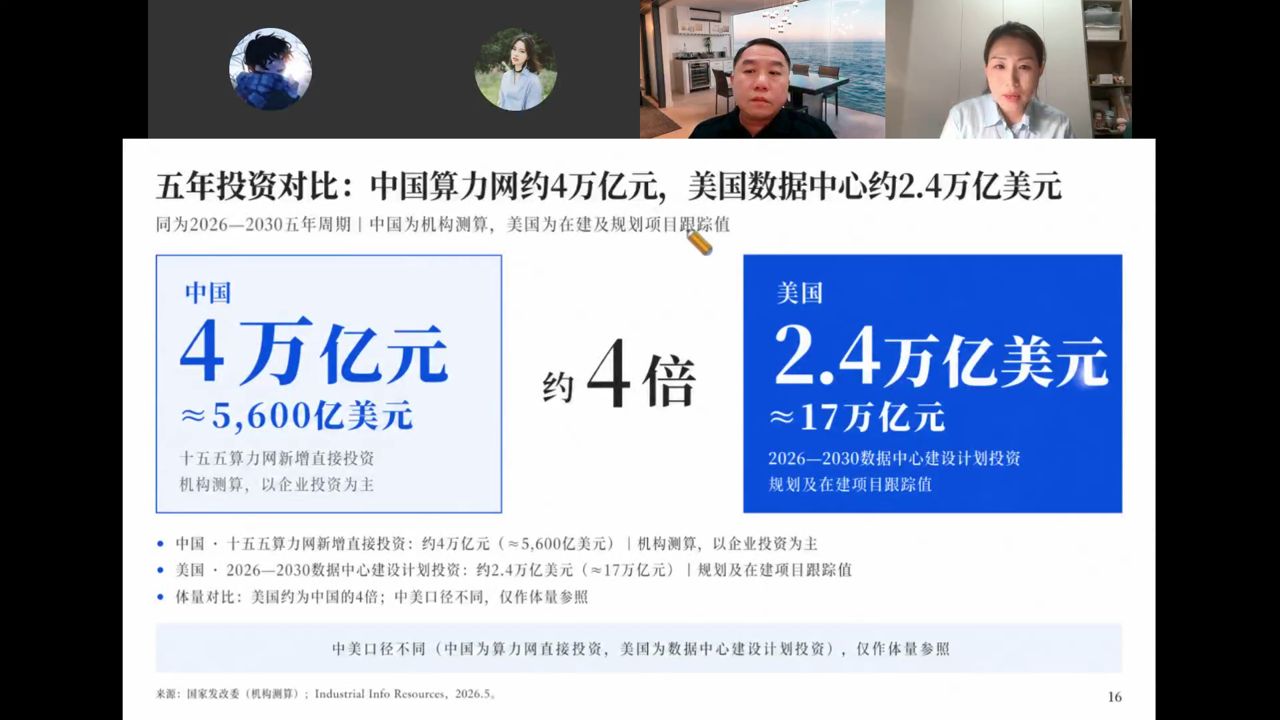
- 中国:十五五算力网新增直接投资约4万亿元(≈5,600亿美元),机构测算,以企业投资为主
- 美国:2026—2030数据中心建设计划投资约2.4万亿美元(≈17万亿元),规划及在建项目跟踪值
- 表面美国约为中国4倍,但口径不同——中国只算算力网,实际加上通信网(约6万亿)和电力网,合计约13—15万亿,修正后差距约2—2.5倍
五、中国AIDC建设:政策与旧中心改造
5.1 旧通算中心能改造成AIDC吗?
结论:能升级的比例并不多。传统通算中心和AIDC对机房面积、承重、供电、冷却的要求完全不同。
具体差距:
- 承重:AIDC同样面积的楼板承重,要比通算中心增加50%-100%,当年规划没留冗余
- 供电:智算中心供电至少是通算中心的3倍以上,涉及外部电网连接
- 液冷:通算中心没有液冷设计,而AIDC万卡集群必须大量使用液冷
- 建设思路:地方政府"重建设轻运营",没有考虑升级换代
5.2 中央政策演进(2022-2026)
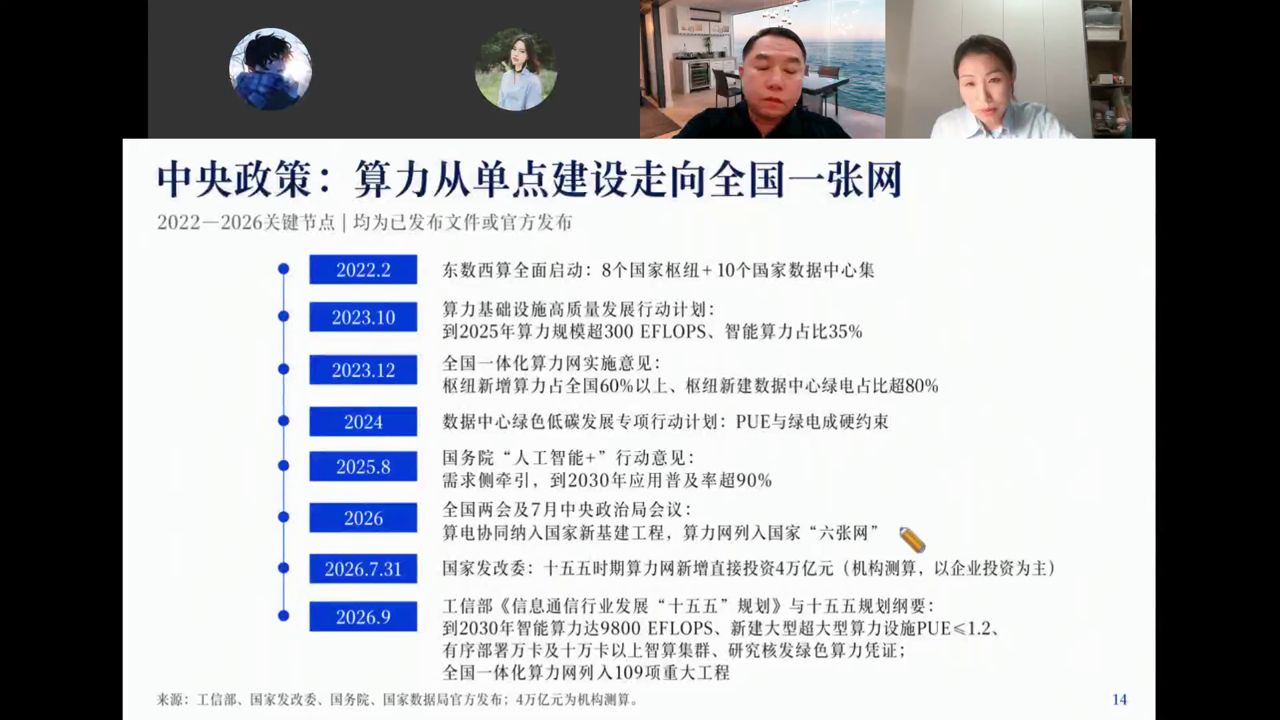
- 2022年:东数西算全面启动,划定8个枢纽、10个国家数据中心集群
- 空间上:从各地自建→收拢到少数枢纽(2023年底要求枢纽新增算力占全国60%以上)
- 目标上:从追求规模→追求效率和绿电(枢纽新建数据中心绿电占比超80%)
- 需求侧:2025年提出AI应用普及率超90%
- 算电协同:算力和电力开始统一统筹
5.3 地方政策差异:东部补需求,西部补能源
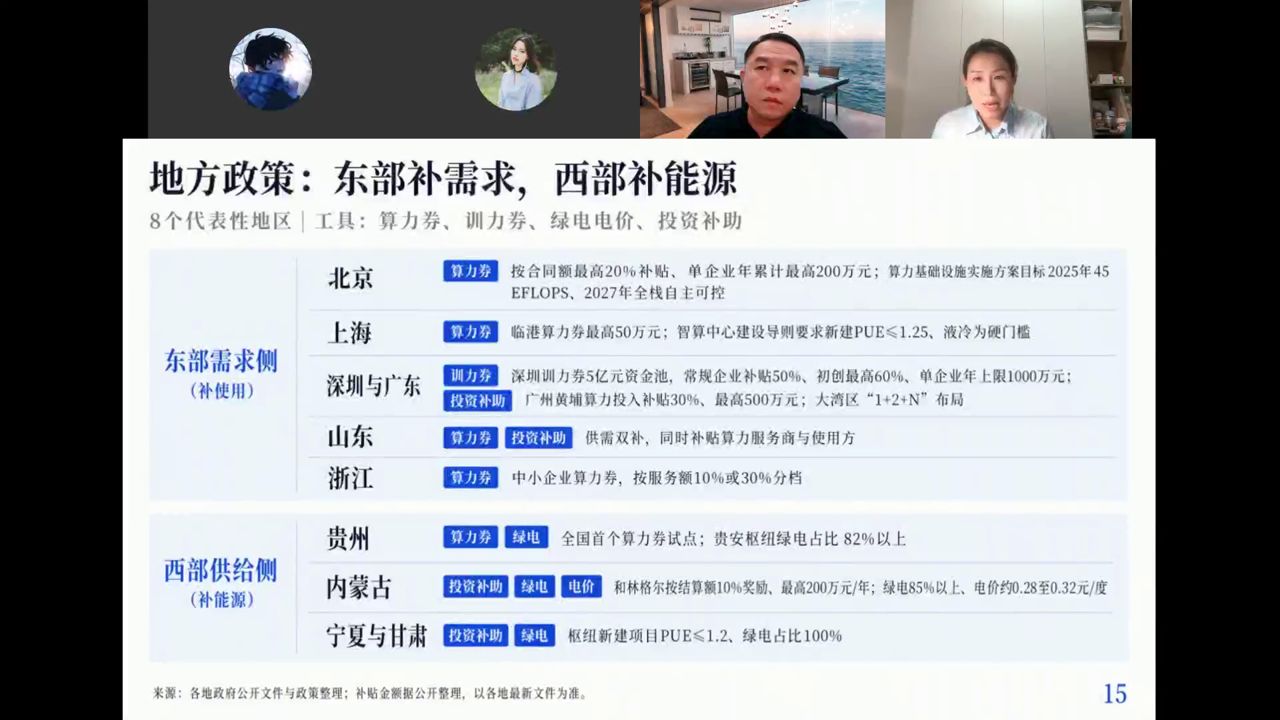
8个代表性地区,工具包括算力券、训力券、绿电电价、投资补助:
- 东部需求侧(补使用):北京算力券按合同额最高20%补贴、单企业年累计最高200万元;上海临港算力券最高50万元、新建PUE≤1.25;深圳训力券5亿元资金池、常规企业补贴50%、初创最高60%、单企业年上限1000万元;广州黄埔算力投入补贴30%、最高500万元;山东供需双补;浙江中小企业算力券按服务额10%或30%分档
- 西部供给侧(补能源):贵州全国首个算力券试点、贵安枢纽绿电占比82%以上;内蒙古和林格尔按结算额10%奖励、最高200万元/年、绿电85%以上、电价约0.28—0.32元/度;宁夏与甘肃枢纽新建项目PUE≤1.2、绿电占比100%
政策优化的方向:早期的算力券、补贴是市场导入期的工具,未来更重要的是全国统筹——能耗指标跨区域调配、算力跨区域调度、绿电跨区域交易。
六、英伟达垄断与国产替代:系统工程弥补
6.1 英伟达独大会结束吗?
3-5年内不会快速结束,但份额会持续被分流。云厂商自研芯片(DSA半定制)主要为自用降本,OpenAI、Anthropic也在设计自己的芯片。预计5年内英伟达云端算力芯片份额可能降到50%以下。
6.2 没有英伟达最先进的卡,靠什么弥补?
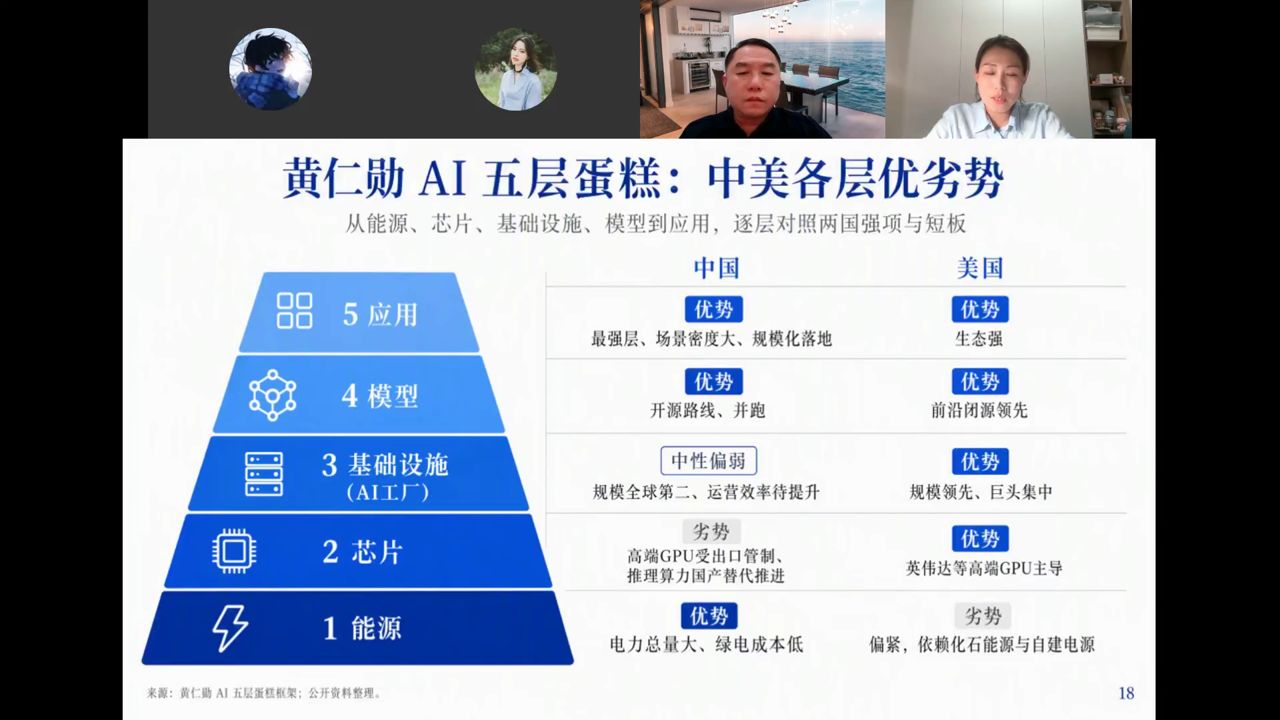
从能源、芯片、基础设施、模型到应用,逐层对照中美强项与短板:
- 第5层 应用:中国优势——最强层、场景密度大、规模化落地;美国优势——生态强
- 第4层 模型:中国优势——开源路线、并跑;美国优势——前沿闭源领先
- 第3层 基础设施(AI工厂):中国中性偏弱——规模全球第二、运营效率待提升;美国优势——规模领先、巨头集中
- 第2层 芯片:中国劣势——高端GPU受出口管制、推理算力国产替代推进中;美国优势——英伟达等高端GPU主导
- 第1层 能源:中国优势——电力总量大、绿电成本低;美国劣势——偏紧,依赖化石能源与自建电源
原则:越尺度越小的东西,弥补难度越大
- 芯片(最小尺度):最难弥补,先进制程是硬约束
- 冷却、供电(大尺度):中国有完整工业体系,完全可以自主实现
可以靠系统工程弥补的:
- 基础设施:液冷、供电、网络架构(中国有制造强项)
- 集群调度、算子优化、流水线切分(超算中心积累)
- 模型创新:DeepSeek用MoE架构、蒸馏技术解决行业推理问题
- 先进封装 + 架构创新:用次优制程 + 堆叠,达到等效算力密度
难以靠系统工程弥补的:
- 先进制程(EUV之前短期难追上)
- 原生大模型训练能力和模型架构创新
- 底层算子库对CUDA的深度优化(但AI辅助迁移正在降低难度)
七、算电协同:电力优势能否转化为算力优势
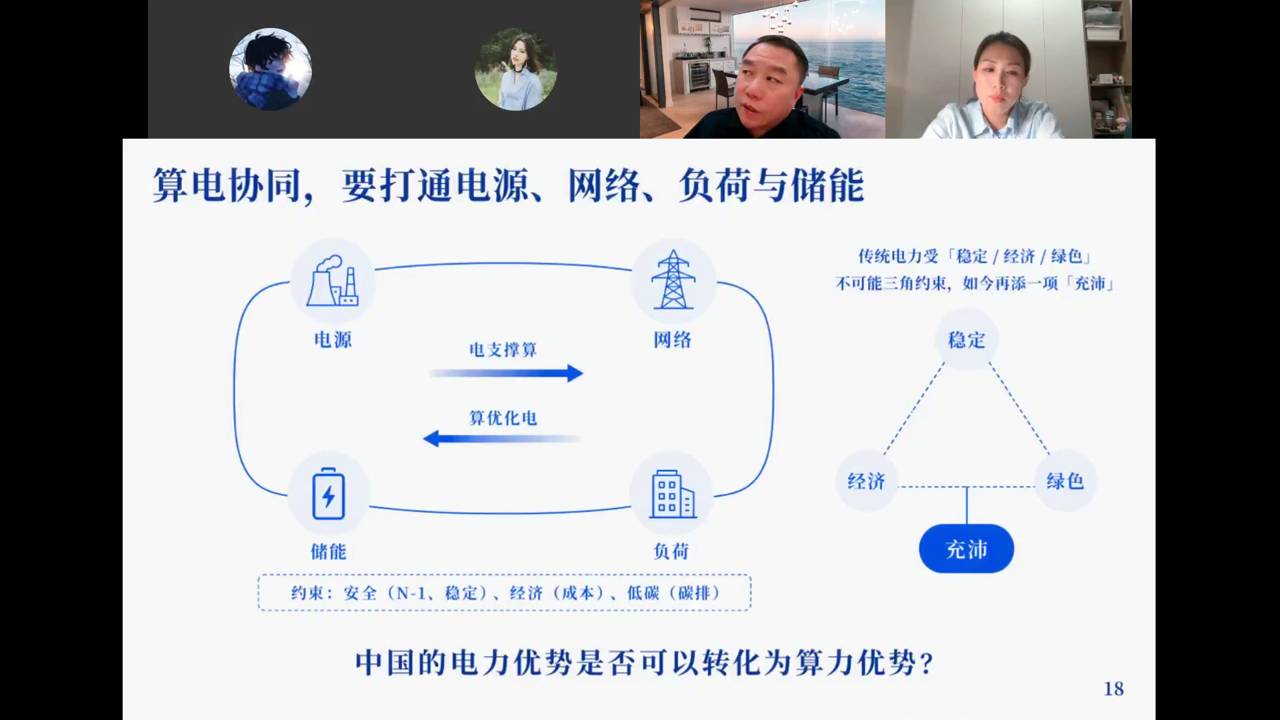
7.1 电力的"不可能四角"
传统电力受"稳定/经济/绿色"不可能三角约束,AIDC时代再加一项"充沛",变成不可能四角。
不同场景、不同业务节点,优先级不同:
- 实时推理:首先保证稳定+充沛,绿色和经济做妥协
- 离线训练:放到西北,可以优先追求低成本和绿电,稳定充沛可以打折扣
- 目标:通过全国算力网跨节点调度,实现全局平衡,而不是单点全部满足
7.2 东数西算在智算时代还有价值吗?
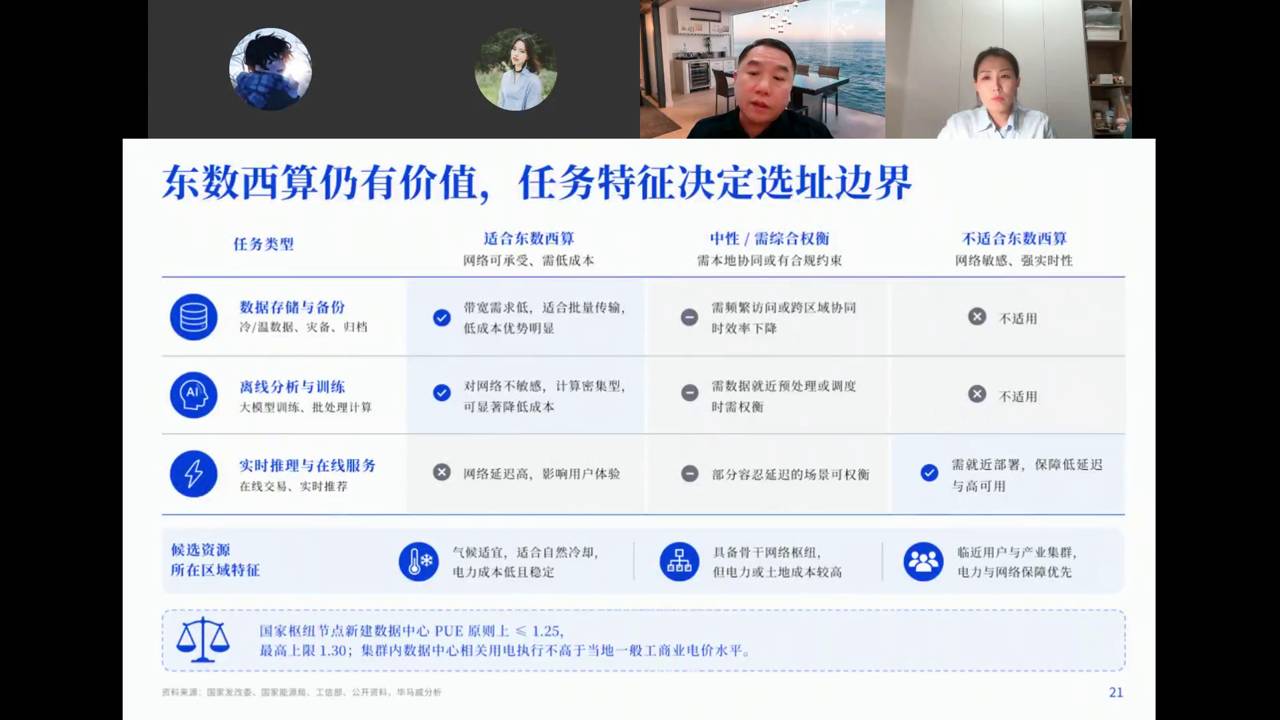
仍然有价值,因为经济重心在东、能源土地重心在西的格局没有本质变化。但任务特征决定选址边界:
- 适合东数西算:数据存储与备份(冷/温数据、灾备、归档)、离线分析与训练(大模型训练、批处理计算)——带宽需求低、对网络不敏感、计算密集型
- 不适合东数西算:实时推理与在线服务(在线交易、实时推荐)——网络延迟高、影响用户体验,需就近部署
- 政策约束:国家枢纽节点新建数据中心PUE原则上≤1.25,最高上限1.30
7.3 跨境电力提供参照,算力变现仍需单独验证
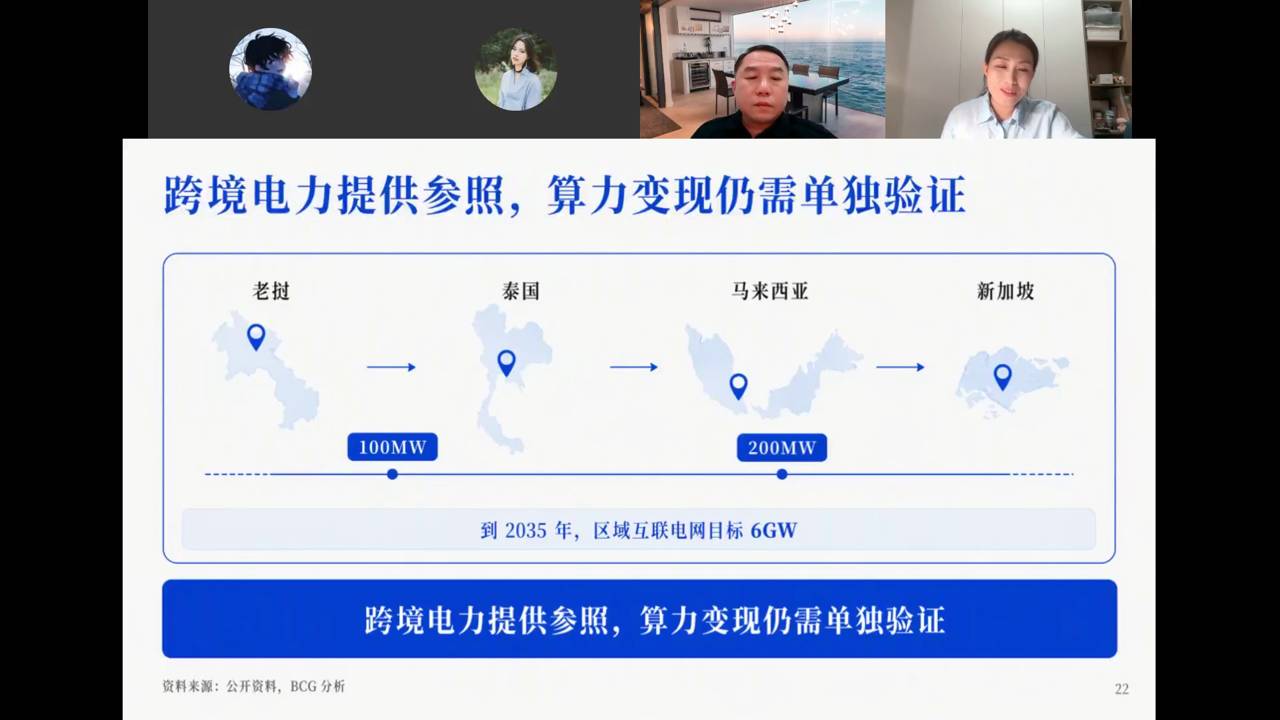
东南亚跨境电力合作已经跑通:老挝100MW→泰国→马来西亚200MW→新加坡,到2035年区域互联电网目标6GW。这说明电力跨境输送是可行的,但算力变现路径和电力输送不同,仍需单独验证。
7.4 中国电力优势到底是什么?
不是电价便宜这么简单,核心是"能马上供得上"
美国最大的问题不是成本,而是扩容跟不上——有需求了、有卡了、机柜立起来了,供配电两年后才能到位,只能自建燃气轮机,但燃气轮机交期也很长。
八、AIDC的六大系统与成本结构
8.1 AIDC的六大系统
计算、网络、存储、供配电、散热,再加上运营管理。任何一段堵住,整套系统的吞吐和能耗效率都上不去。
8.2 成本构成(以200亿AIDC项目为例)
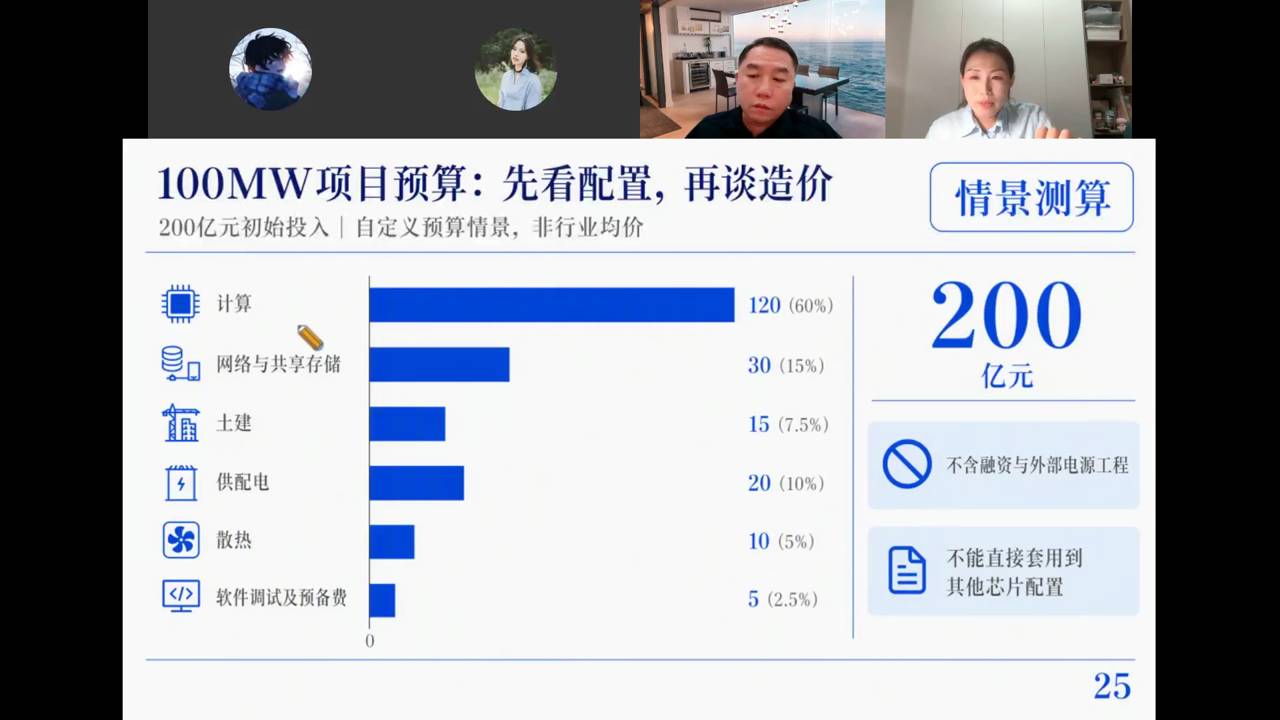
- 计算(GPU):120亿,占60%——最大头
- 网络与共享存储:30亿,占15%
- 供配电:20亿,占10%
- 土建:15亿,占7.5%
- 散热:10亿,占5%
- 软件调试及预备费:5亿,占2.5%
注:不含融资与外部电源工程,不能直接套用到其他芯片配置。
8.3 三个核心运营指标
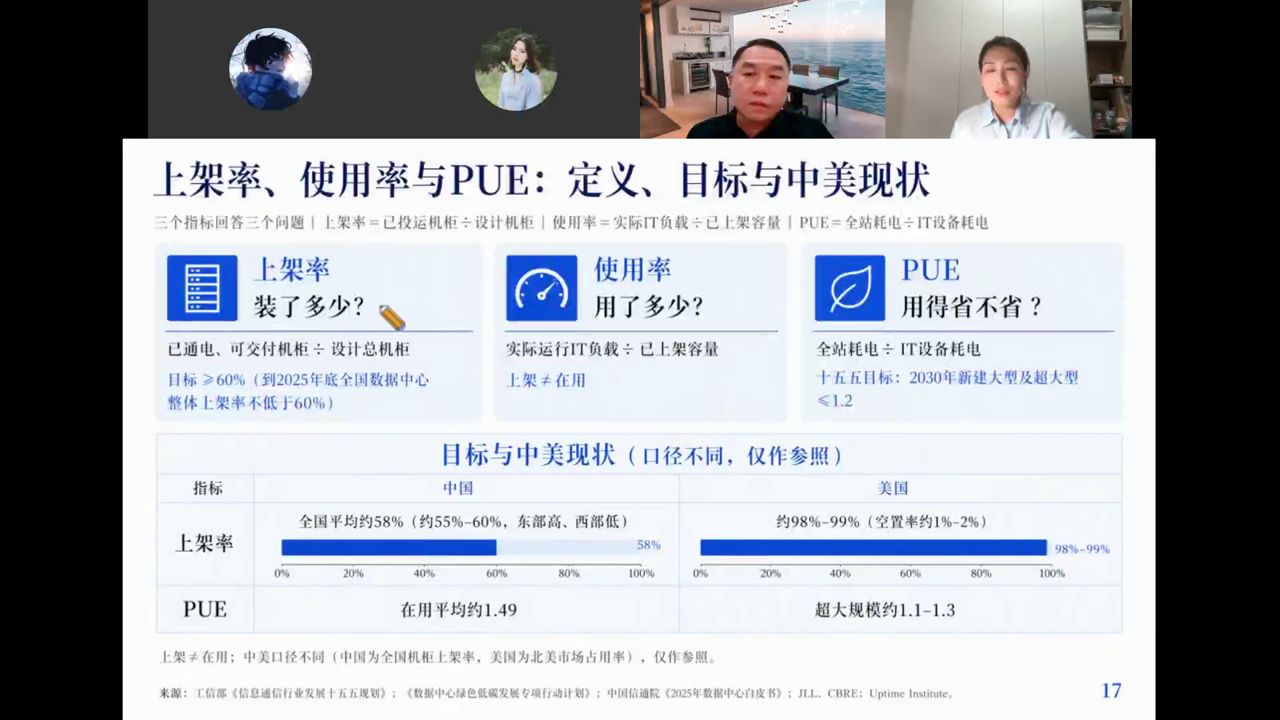
- 上架率:装了多少?已通电可交付机柜÷设计总机柜。中国全国平均约58%,美国约98%-99%
- 使用率:用了多少?实际运行IT负载÷已上架容量。上架≠在用
- PUE:用得省不省?全站耗电÷IT设备耗电。中国在用平均约1.49,美国超大规模约1.1-1.3。十五五目标:2030年新建大型及超大型≤1.2
8.4 企业自建 vs 租赁
企业选择自建算力中心,主要两种场景:
- 数据安全/合规要求:行业合规要求或心理上的数据安全感
- 自用量足够大:自用算力的量达到"账算得过来"的规模,因为最大成本不在建设而在运营维护(要养团队、持续花钱)
8.5 供配电升级:交流、混合架构与800V直流并行
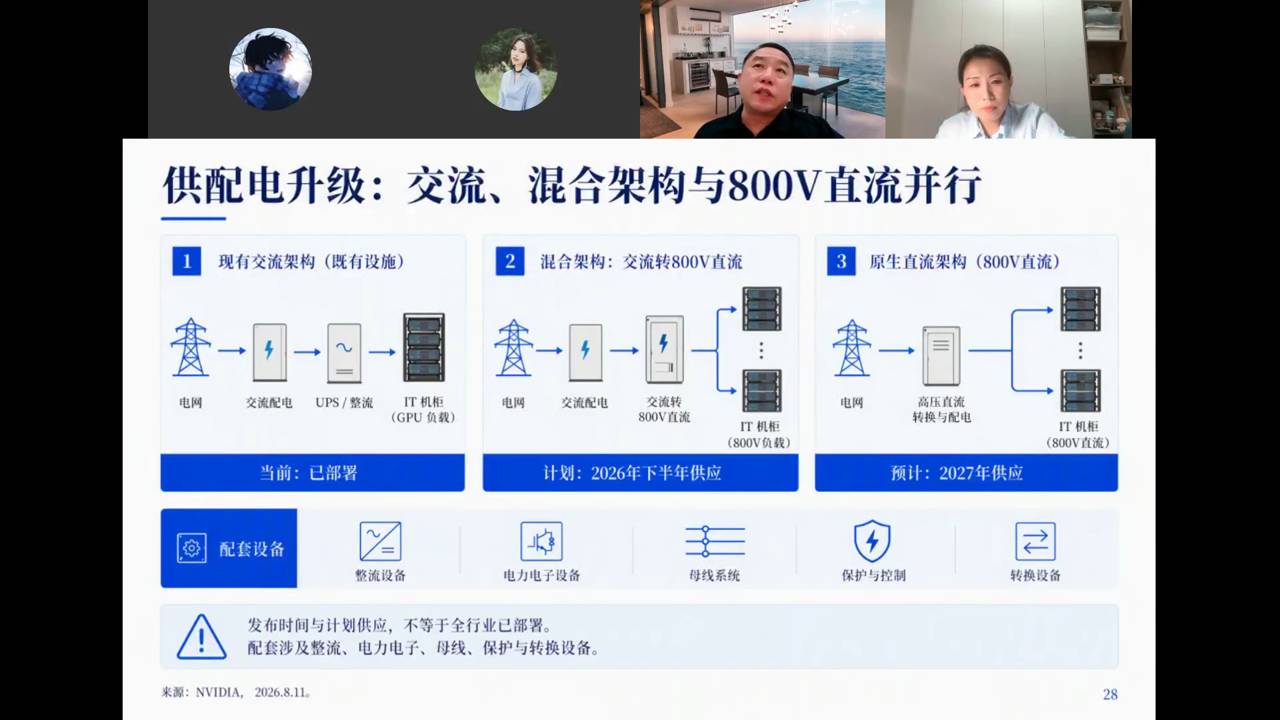
供配电架构正在三代并行迭代:
- 现有交流架构(已部署):电网→交流配电→UPS/整流→IT机柜
- 混合架构(2026下半年供应):交流转800V直流,逐步过渡
- 原生直流架构(预计2027年):高压直流转换与配电,直接供800V负载
8.6 现场发电与储能,解决不同时间尺度的问题
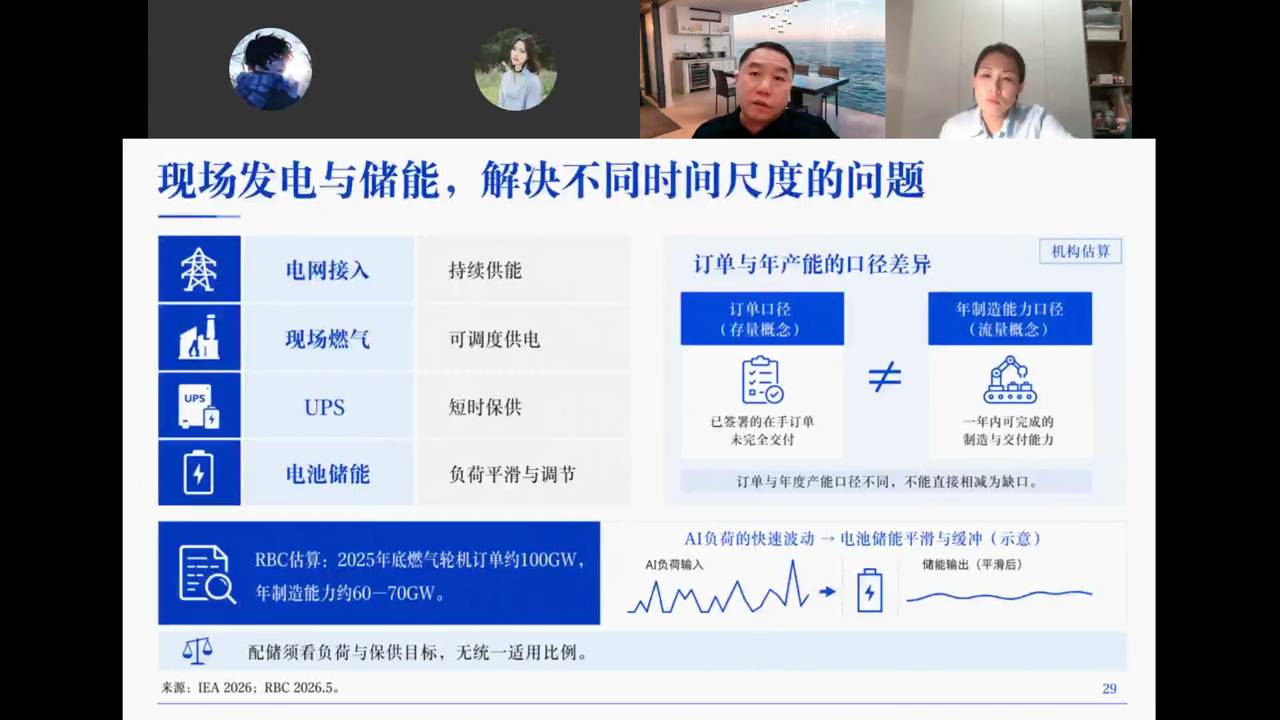
不同时间尺度的供电需求由不同方式解决:
- 电网接入:持续供能(长期稳定)
- 现场燃气轮机:可调度供电(RBC估算2025年底燃气轮机订单约100GW,年制造能力约60-70GW)
- UPS:短时保供(秒级)
- 电池储能:负荷平滑与调节(AI负荷快速波动→电池储能平滑缓冲)
8.7 模块化交付:缩短工期,仍须等电等设备
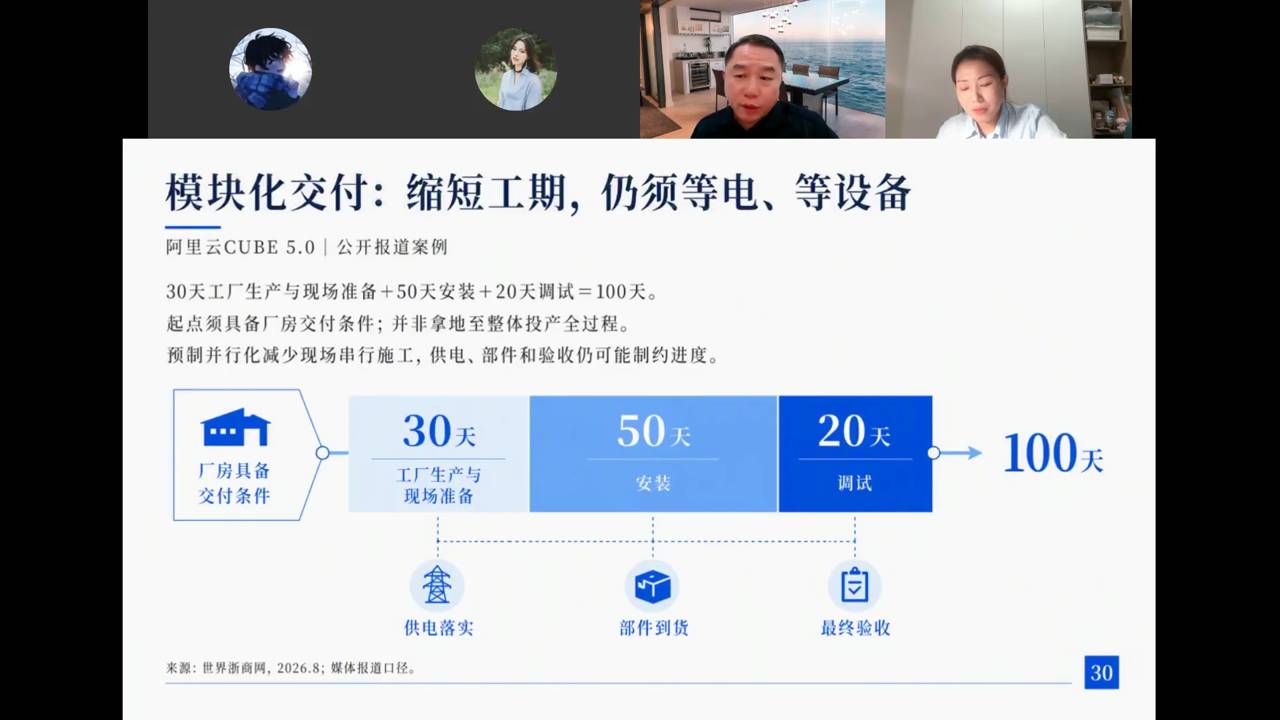
以阿里云CUBE 5.0为例:30天工厂生产与现场准备 + 50天安装 + 20天调试 = 100天(起点须具备厂房交付条件)。预制并行化减少现场串行施工,但供电、部件到货和最终验收仍可能制约进度。
九、还要建多久,会不会重蹈光伏覆辙?
9.1 现在是全面过剩,还是结构性短缺?
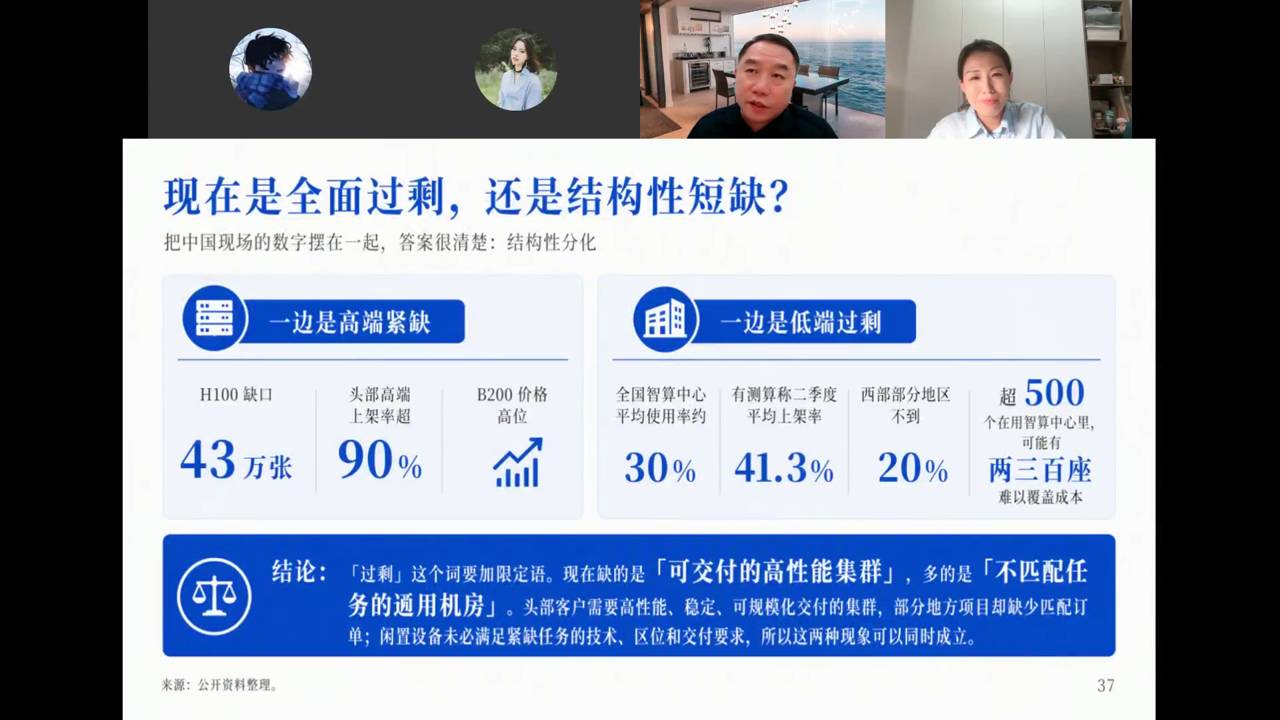
把中国现场的数字摆在一起,答案很清楚:结构性分化。
一边是高端紧缺:
- H100缺口约43万张
- 头部智算中心上架率超90%
- B200价格高位
一边是低端过剩:
- 全国智算中心平均使用率约30%
- 有测算称二季度平均上架率41.3%
- 西部部分地区不到20%
- 超500个在用智算中心里,可能有两三百座难以覆盖成本
结论:「过剩」这个词要加限定语
现在缺的是「可交付的高性能集群」,多的是「不匹配任务的通用机房」。头部客户需要高性能、稳定、可规模化交付的集群,部分地方项目却缺少匹配订单;闲置设备未必满足紧缺任务的技术、区位和交付要求,所以这两种现象可以同时成立。
核心观点总结
第一,本轮全球AIDC建设热潮是需求、供给、预期三者共振的结果。60-70%是确定需求,30-40%是抢资源的提前布局。
第二,算力密度提升是本轮扩张的核心驱动力,不是靠建新楼,而是靠先进制程+先进封装让单站点算力密度大幅提升。
第三,中美算力模式差异明显:美国多超级大站点,中国更分散(合建模式+训练西移推理东移)。中国单站点排名不高,但总量在快速追赶。
第四,旧通算中心很难改造成AIDC,承重、供电、液冷都不匹配,大多数只能当冗余。
第五,没有英伟达最先进的卡,靠系统工程可以弥补大部分:基础设施(液冷供电)、集群调度、模型创新(MoE、蒸馏)、先进封装。但先进制程和原生大模型能力仍有差距。
第六,中国电力优势的核心不是便宜,而是"能马上供得上"。东数西算在智算时代仍然有价值,但要区分训练(放西部)和推理(靠近用户)。
第七,100MW智算中心约200亿初始投入,GPU占60%。供配电正从交流向800V直流演进,模块化交付可压缩到100天,但供电和部件到货仍是瓶颈。
第八,当前是结构性分化而非全面过剩:高端H100缺口43万张、头部上架率90%,低端全国使用率仅30%、西部不到20%。缺的是可交付的高性能集群,多的是不匹配任务的通用机房。