260606韬定律下的先进工艺+涨价浪潮下的成熟制程
本期两条主线:一是华为"韬定律"(逻辑折叠)如何用 3D 堆叠绕开没有 EUV 的瓶颈、直接利好晶圆厂; 二是成熟制程涨价潮全面开启。同时梳理了国产算力新变化(CPU 数量爆发、PCIe Switch)、 长鑫长存扩产链,以及模拟、功率、分销等成熟制程环节的量价机会。
课程目录
一、韬定律:设计阶段的逻辑折叠,绕开 EUV 瓶颈
韬定律(逻辑折叠)走的是与传统封装不同的路径:不是在封装阶段把多个独立芯片叠起来,而是在设计阶段就把一颗芯片内部的电路,下沉到逻辑门和触发器级别,垂直堆叠到多层晶圆中。原本一颗芯片只需一颗 die,现在需要 2–3 颗甚至更多(SRAM、内存控制器等),意味着先进逻辑晶圆的需求成倍提升。
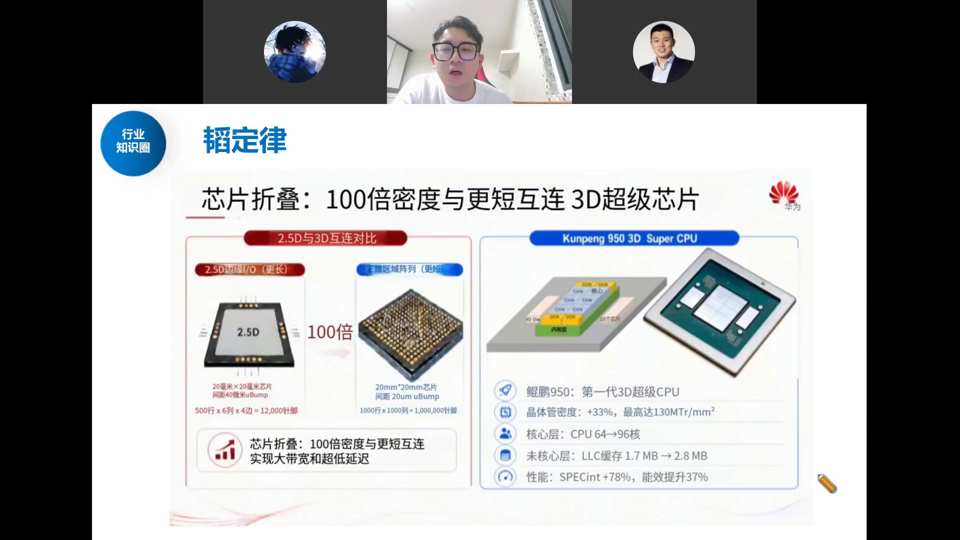
这是华为用鲲鹏 950 落地的第一代 3D 超级 CPU:通过 2.5D 到 3D 互连的升级,晶体管密度较 2.5D 提升约 100 倍(同面积下从 1.2 万针脚跃升到 1 万针脚级别的 3D 阵列),晶体管密度 +33%、最高达 130MT/tr/mm²,核心 64–96 核,未核 LLC 缓存从 1.7MB 扩到 2.8MB,SPECint +78%、能效提升 37%。
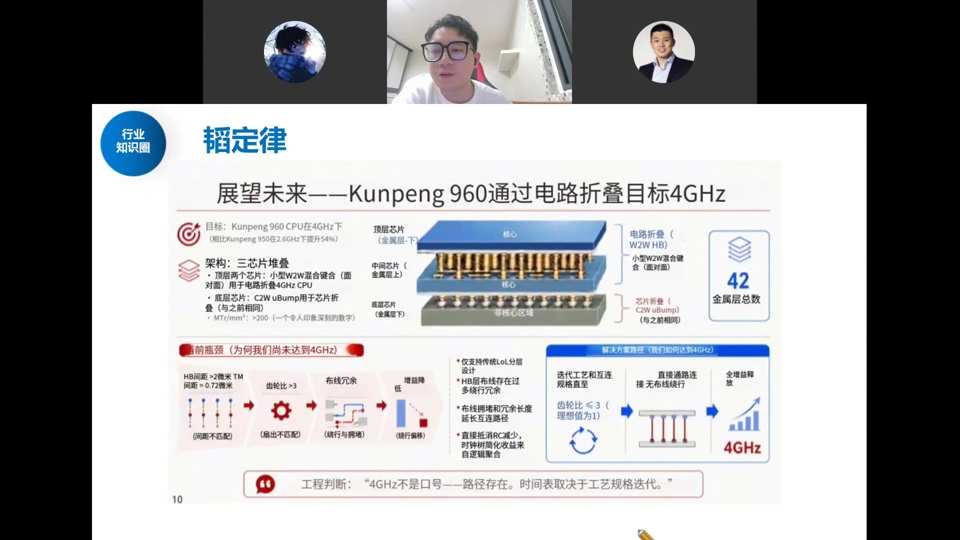
进一步展望,华为白皮书披露 Kunpeng 960 将通过电路折叠向 4GHz 频率目标迈进(现 Kunpeng 950 在 2.8GHz 已提升 54%)。架构采用三芯片堆叠:顶层 W2W 混合键合(面对面对)、中间 W2W HB、底层 C2W uBump,全片金属层总数达 42 层。未达 4GHz 的瓶颈在 HB Pitch 仍 >1μm、布线冗余和余长;解决方案是迭代工艺互连网络规整化、直连通路减少布线绕行。工程判断:4GHz 不是口号,路径存在,时间表取决于工艺规格迭代。
研究员自研测算了需要先进制程的各类芯片(算力芯片、交换芯片、IO 芯片、DRAM CBA Logic Die、HBM Logic Die、手机/PC/消费电子等)对应的外协制程晶圆需求(KWPM),加上逻辑折叠后的市场规模成倍增加,远期(2026–2027 年起)爆发。
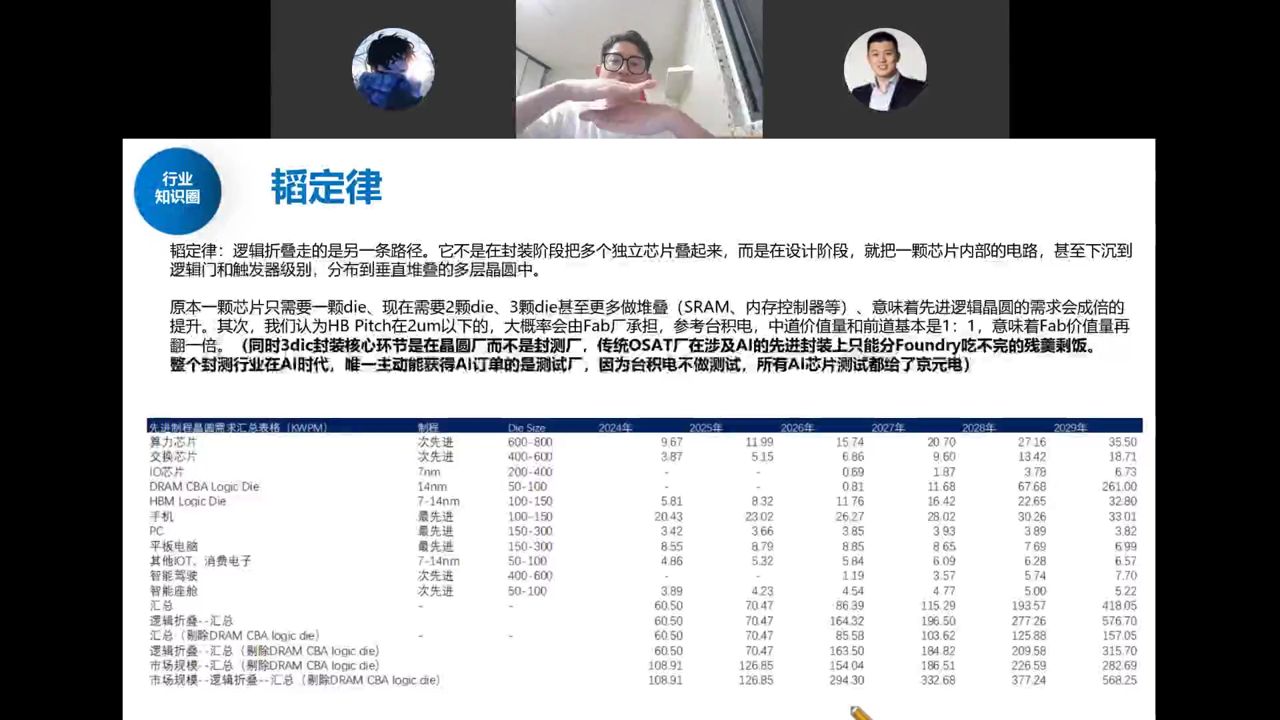
谁最受益(市场误区澄清):最直接利好的是晶圆厂(Fab),而不是封测厂。HP Pitch 在 2μm 以下大概率由 Fab 厂承担,参考台积电 Corvus/CoWoS 模式——先进封装在设计阶段就由晶圆厂完成,传统 OSAT(日月光等)只能吃到 Foundry 做不完的残羹剩饭。AI 时代唯一主动拿到 AI 订单的封测环节是测试厂(台积电不做测试,所有 AI 芯片测试都给了京元电)。
测算显示:加上逻辑折叠后,远期(2026–2027 年起)晶圆需求市场空间成倍增加(外协制程晶圆需求从 2024 年约 109 万片/月增至 2029 年约 568 万片/月)。这直接打破了国内"没有 EUV 就做不了先进制程 AI 芯片"的瓶颈,拉动晶圆厂新制程扩产,以及混合键合设备、检测测试设备等新型增量。
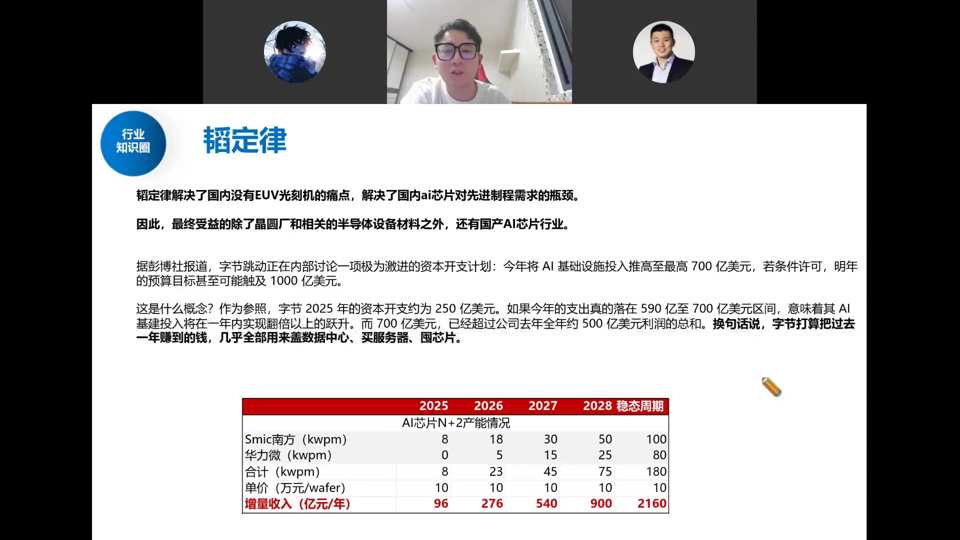
韬定律解决的是国内没有 EUV 光刻机的痛点,最终受益除晶圆厂和设备材料外,还有国产 AI 芯片行业。彭博报道字节跳动正讨论激进资本开支:今年 AI 基础设施投入推高至最高 700 亿美元,明年预算目标甚至触及 1000 亿美元(2025 年才约 250 亿美元)。下表测算了 Smic 南方与华力微(华虹集团非上市主体)的 AI 芯片 N+2 产能规划:从 2025 年合计 8KWPM 扩到稳态 180KWPM,对应增量收入从 96 亿/年增至 2160 亿/年。
二、国产算力新变化:CPU 数量爆发与 PCIe Switch
AI 负载从训练转向推理,CPU 从"发号施令的指挥家"变成"反复与 GPU 沟通的保姆"(任务拆解、分步反馈、调试修改)。智能体(Agent)需要动态规划、工具调用、任务编排,过去 CPU 里 64 个核有 70% 闲着,未来每个核都要高速运转。
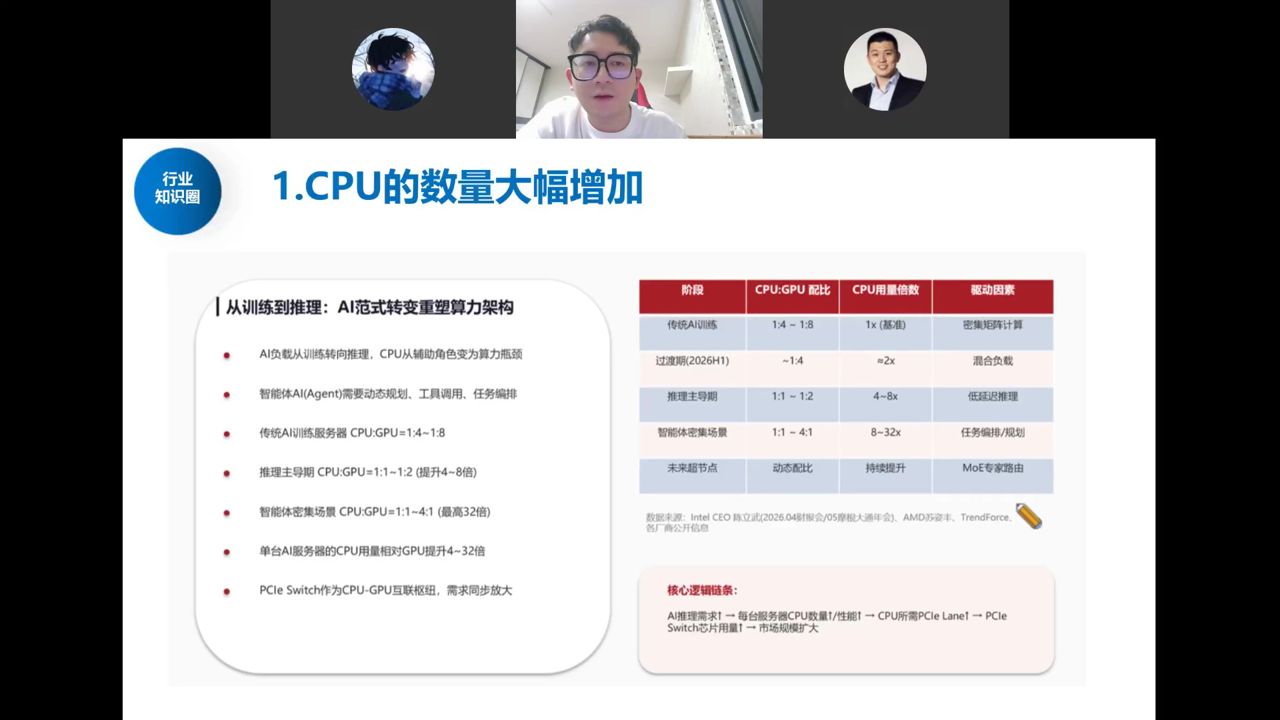
- 配比跃迁:传统 AI 训练 CPU:GPU = 1:4~1:8;推理主导期 1:1~1:2;智能体密集场景 1:1~4:1。单台服务器 CPU 用量相对 GPU 提升 4–32 倍。
- 逻辑链条:AI 推理需求↑ → 每台服务器 CPU 数量/性能↑ → CPU 所需 PCIe Lane↑ → PCIe Switch 交换芯片用量↑。一颗 CPU 外围只有约 16 条 PCIe 通道,需用 Switch 芯片(如博通 PEX8796,96 通道)拓宽到几百条,每个 CPU 旁配两颗。
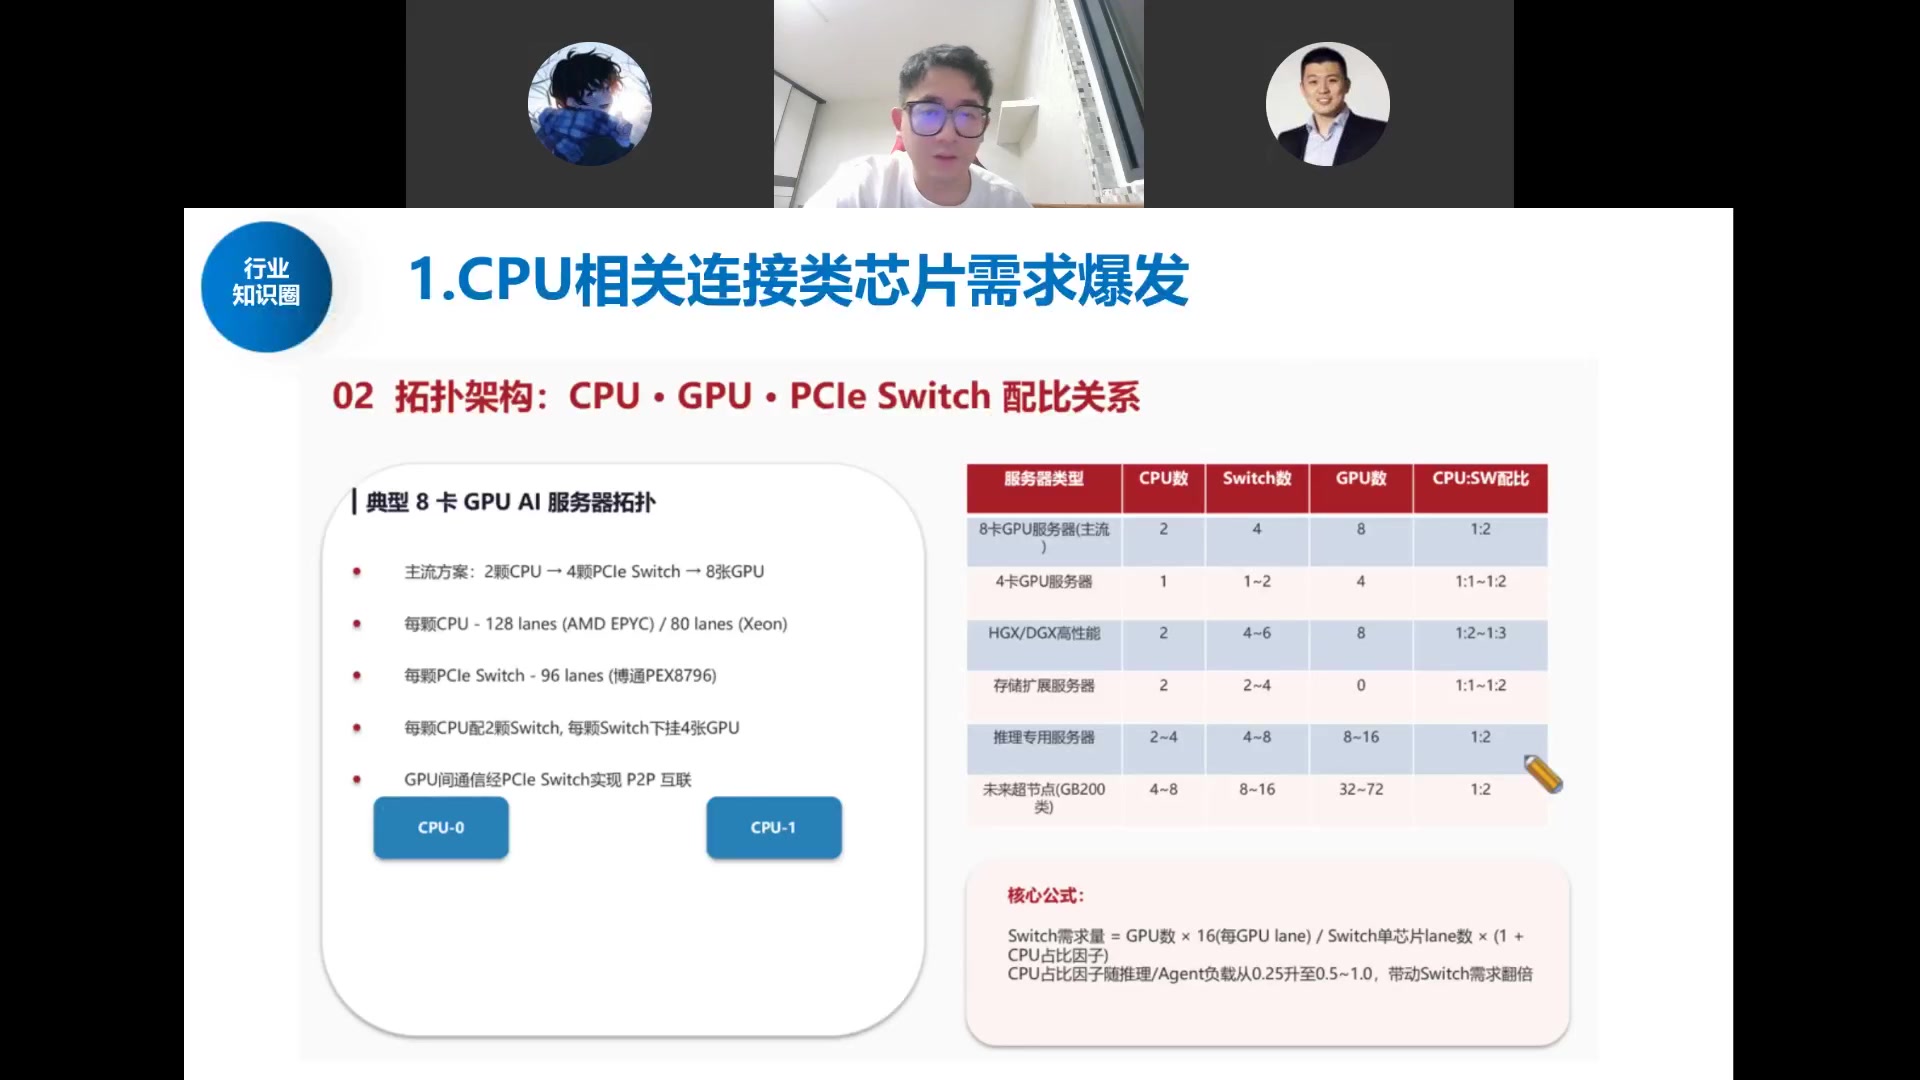
具体拓扑:主流 8 卡 GPU AI 服务器用 2 颗 CPU → 4 颗 PCIe Switch → 8 张 GPU。每颗 CPU 约 128 lanes(AMD EPYC)/80 lanes(Xeon),每颗 Switch 96 lanes(博通 PEX8796),每颗 CPU 配 2 颗 Switch、每颗 Switch 下挂 4 张 GPU。推理服务器 CPU:GPU 配比升至 1:2~1:4,未来超节点(GB200 类)单托盘需 CPU 4–8 颗、Switch 8–16 颗、GPU 32–72 颗。
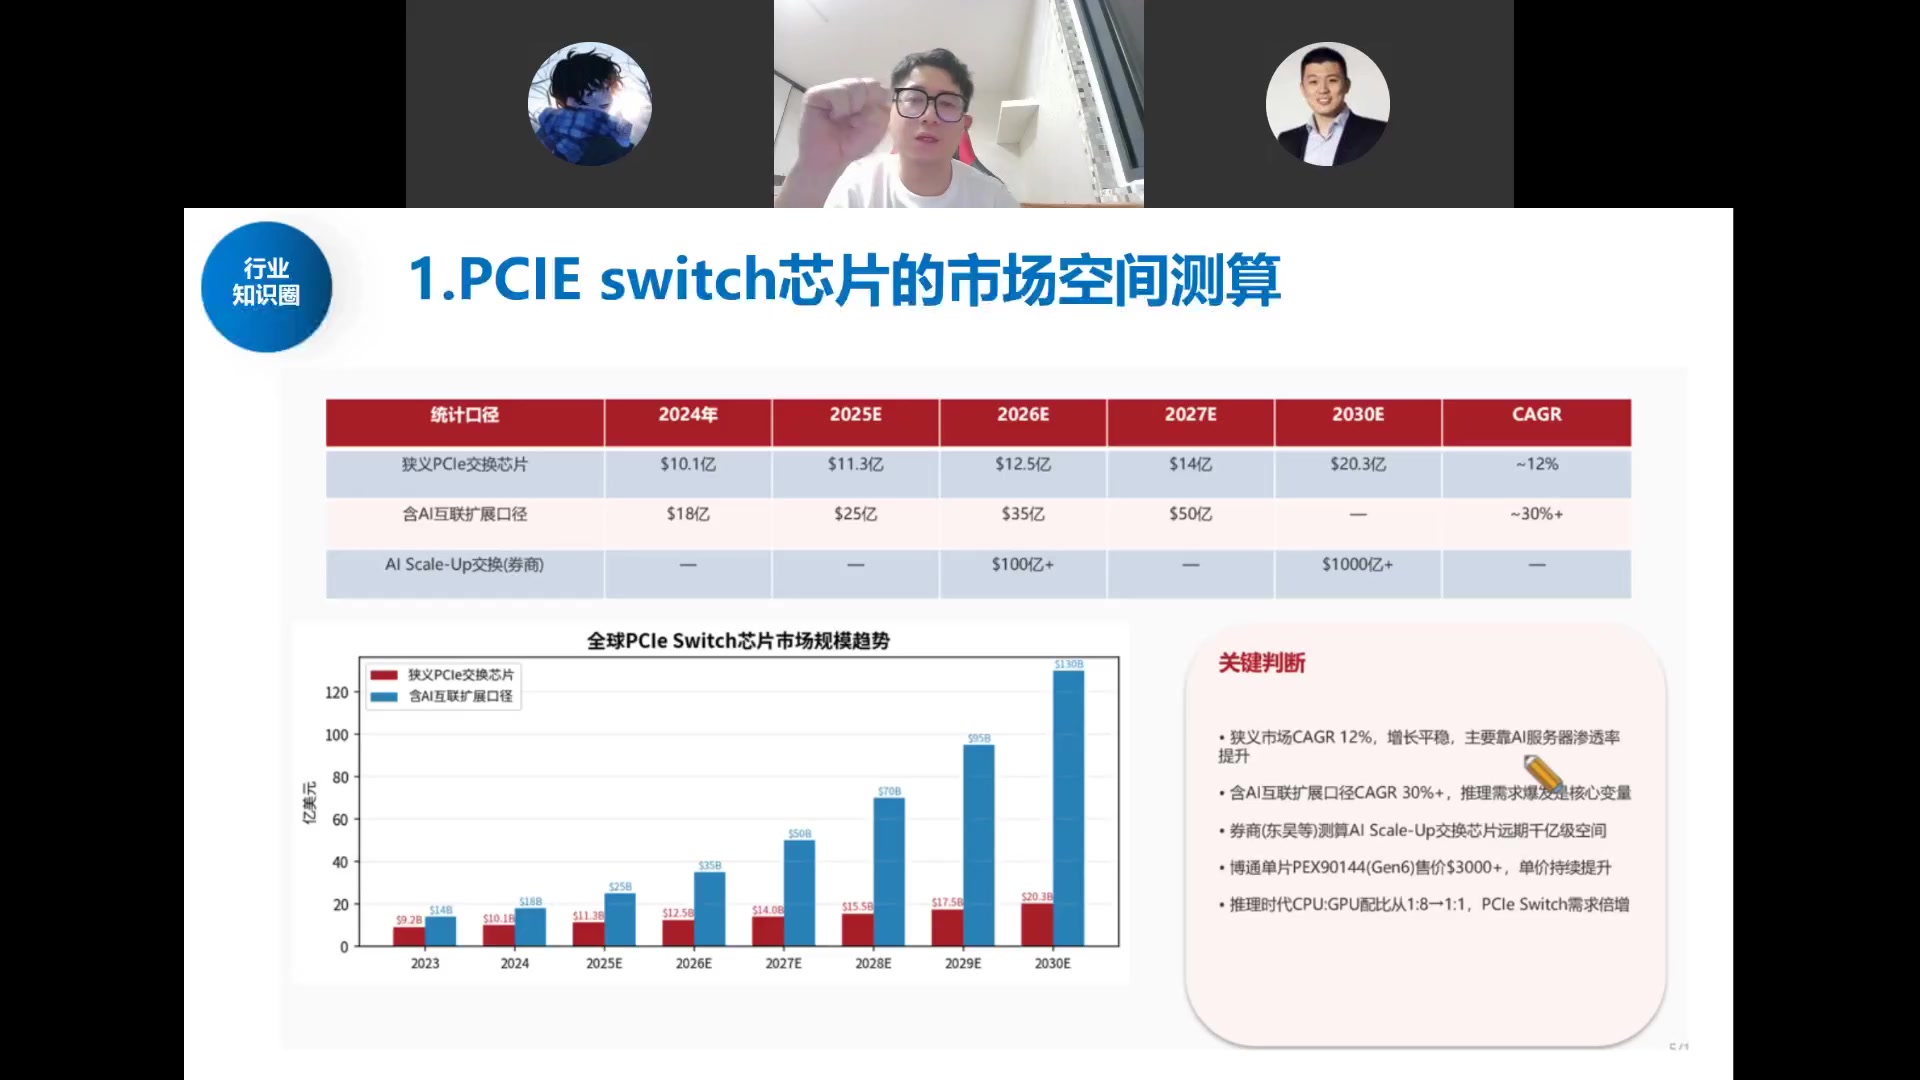
市场空间测算:狭义 PCIe 交换芯片 2024 年约 $10.1 亿、2030E $20.3 亿(CAGR ~12%,靠 AI 服务器渗透率提升);含 AI 互联扩展口径 2024 年 $18 亿→2027E $50 亿(CAGR ~30%+,推理需求爆发是核心变量);券商(东吴等)测算 AI Scale-Up 交换芯片 2026E 即超 $100 亿、2030E 远期千亿美金。博通 PEX90144(Gen6)单片售价 $3000+ 且单价持续提升。
需求佐证:字节今年 AI 资本开支上调到 700 亿美元、明年上修到 1000 亿美元,未来三年合计 2.1 万亿人民币以上(半年前还以为只有 1 万亿出头)。CPU、内存接口芯片、Switch 芯片等配套器件需求同步"加个零"。
三、成熟制程涨价潮:代工资源全面紧缺
国内成熟代工处于结构性高景气、周期上行中段:头部满产、AI+汽车双驱动、国产替代加速扩产,海外芯片厂"China for China"(卖给中国的货必须在中国制造)纷纷找国内晶圆厂代工。
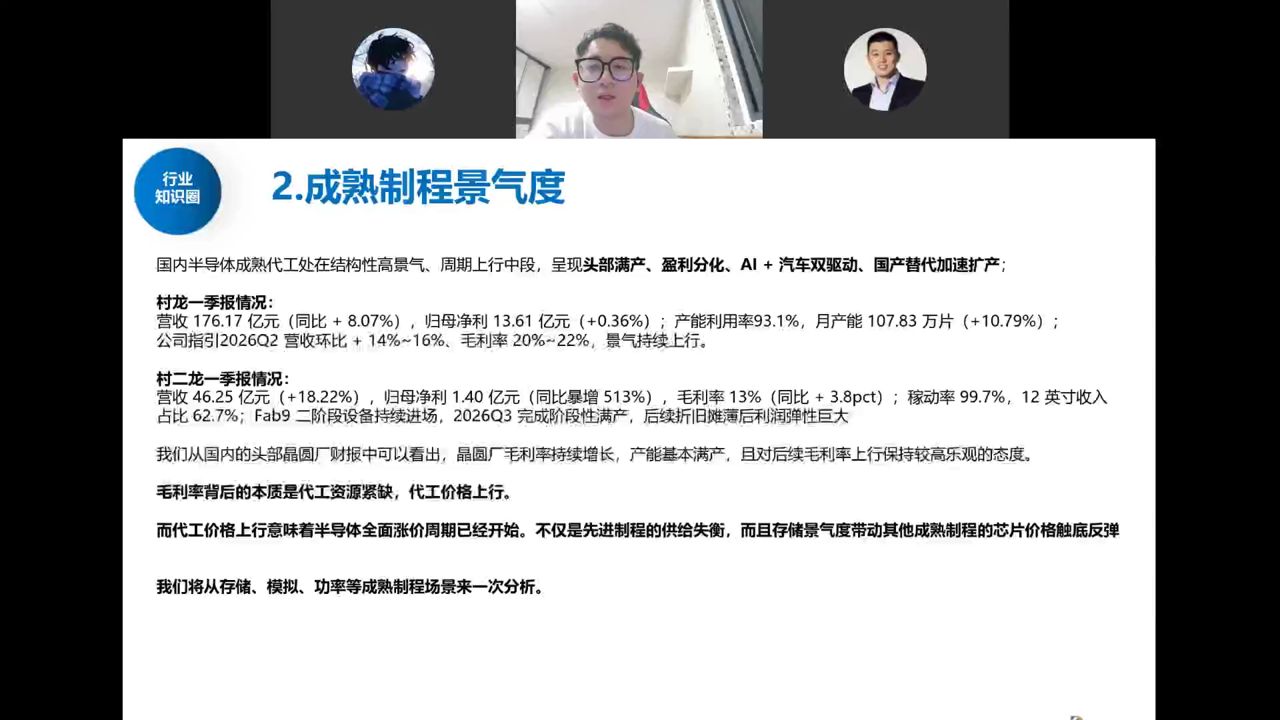
- 中芯国际(村龙一):营收 176.17 亿(+8.07%),产能利用率 93.1%,月产能 107.83 万片;指引 2026Q2 营收环比 +14~16%、毛利率 20~22%。
- 华虹(村龙二):营收 46.25 亿(+18.22%),归母净利同比暴增 513%,稼动率 99.7%,12 英寸占比 62.7%;Fab9 二阶段进场,2026Q3 完成阶段性满产。
毛利率上行的本质是代工资源紧缺、代工价格上涨。下游只要沾 AI/服务器需求,"有没有价格不重要,有货就行",成本顺畅传导。研究员判断:代工价格上行意味着半导体全面涨价周期已经开始——不仅先进制程供给失衡,存储景气还会带动成熟制程芯片价格触底反弹,像多米诺骨牌逐轮推动。成熟制程的核心就看价格(国产化率已高,利润靠涨价释放)。
四、存储:长鑫长存扩产链是核心
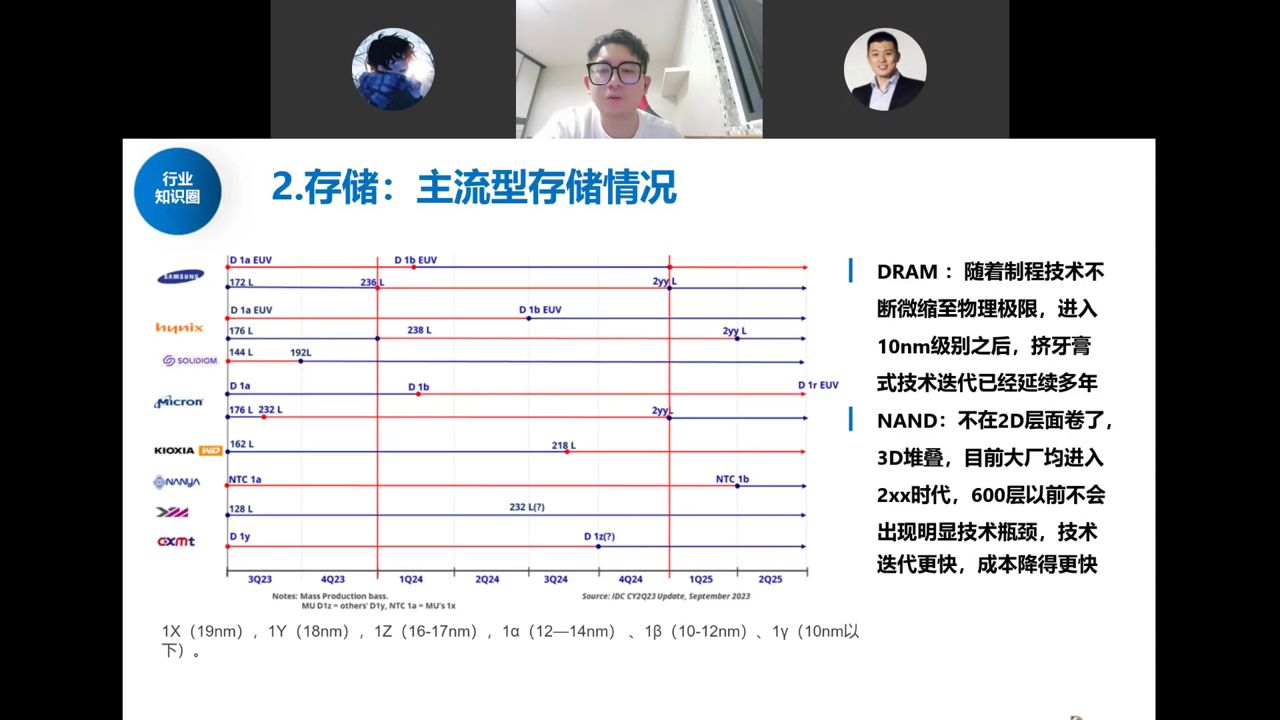
主流存储分两类:DRAM(断电丢失数据,与 GPU/CPU 交换数据,代表是 HBM,国内长鑫)和 NAND Flash(持久存海量数据,国内长江存储)。两者都不吃先进制程、不依赖 EUV,光刻机无法卡脖子,扩产没有技术阻挠,因此背负国家级扩产重任。
长鑫科技是国内规模最大、技术最先进、布局最全的 DRAM IDM,2016 年成立以来"跳代研发",已完成第一代到第四代工艺平台量产,产品覆盖 DDR4/LPDDR4X 到 DDR5/LPDDR5/5X,核心工艺达国际先进水平。存货规模持续攀升蓄力扭亏:2025H1 存货已达 260.9 亿元、超过 2024 全年;按全年预测 2025Q4 营收 244 亿、净利润 87.5 亿、归母净利 42 亿创历史新高。
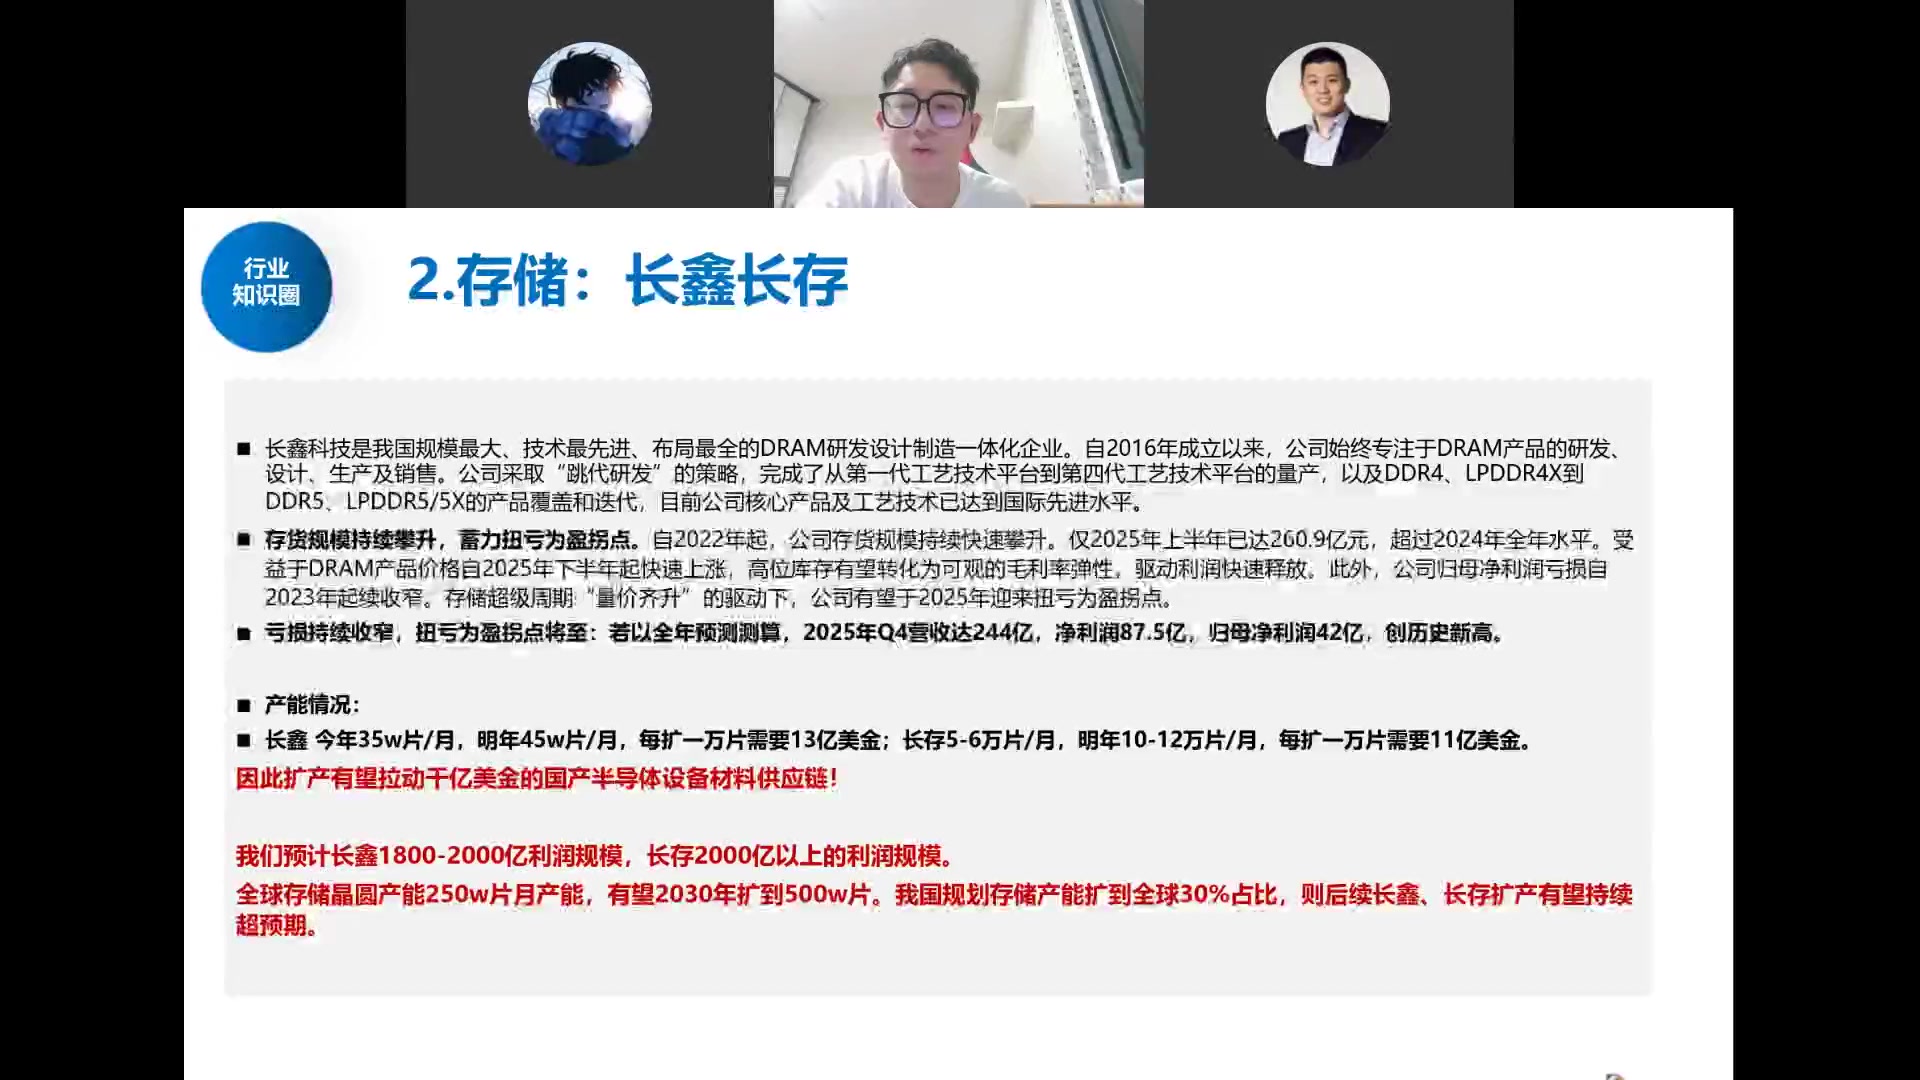
- 利润体量:长鑫今年一季度利润已近 300 亿,全年有望 1800 亿以上(约等于 2 个宁德时代);长存不考虑新厂折旧的净现金流增量在 2000 亿以上。2027 年预计长鑫约 3000 亿、长存约 4000 亿利润——给 10 倍 PE 就是 4 万亿市值。
- 扩产空间:全球晶圆产能现约 250 万片/月,2030 年要扩到 500 万片;中国规划存储产能占全球 30%(约 150 万片),目前长鑫约 35 万、长存约 10 万片,远期需大幅扩张。长鑫今年 35w 片/月、明年 45w,每扩 1 万片需 13 亿美金;长存 5–6w 片/月、明年 10–12w,每扩 1 万片需 11 亿美金——扩产有望拉动千亿美金国产设备材料链。
重点:长鑫长存上市后不是"炒一波就结束"——它们募资有限,后续要靠定增从二级市场借钱扩产,每一笔定增都是数百亿上千亿。必须重视两长的扩产链:长鑫(合肥)产业链已较透明,长存(武汉)配套仍有大量想象空间。存储周期短期 1–3 年内看不到结束——只要价格敢跌就有人敢囤货补库。
五、模拟与功率:AI 带来的量价齐升
模拟芯片(两大高景气料号)
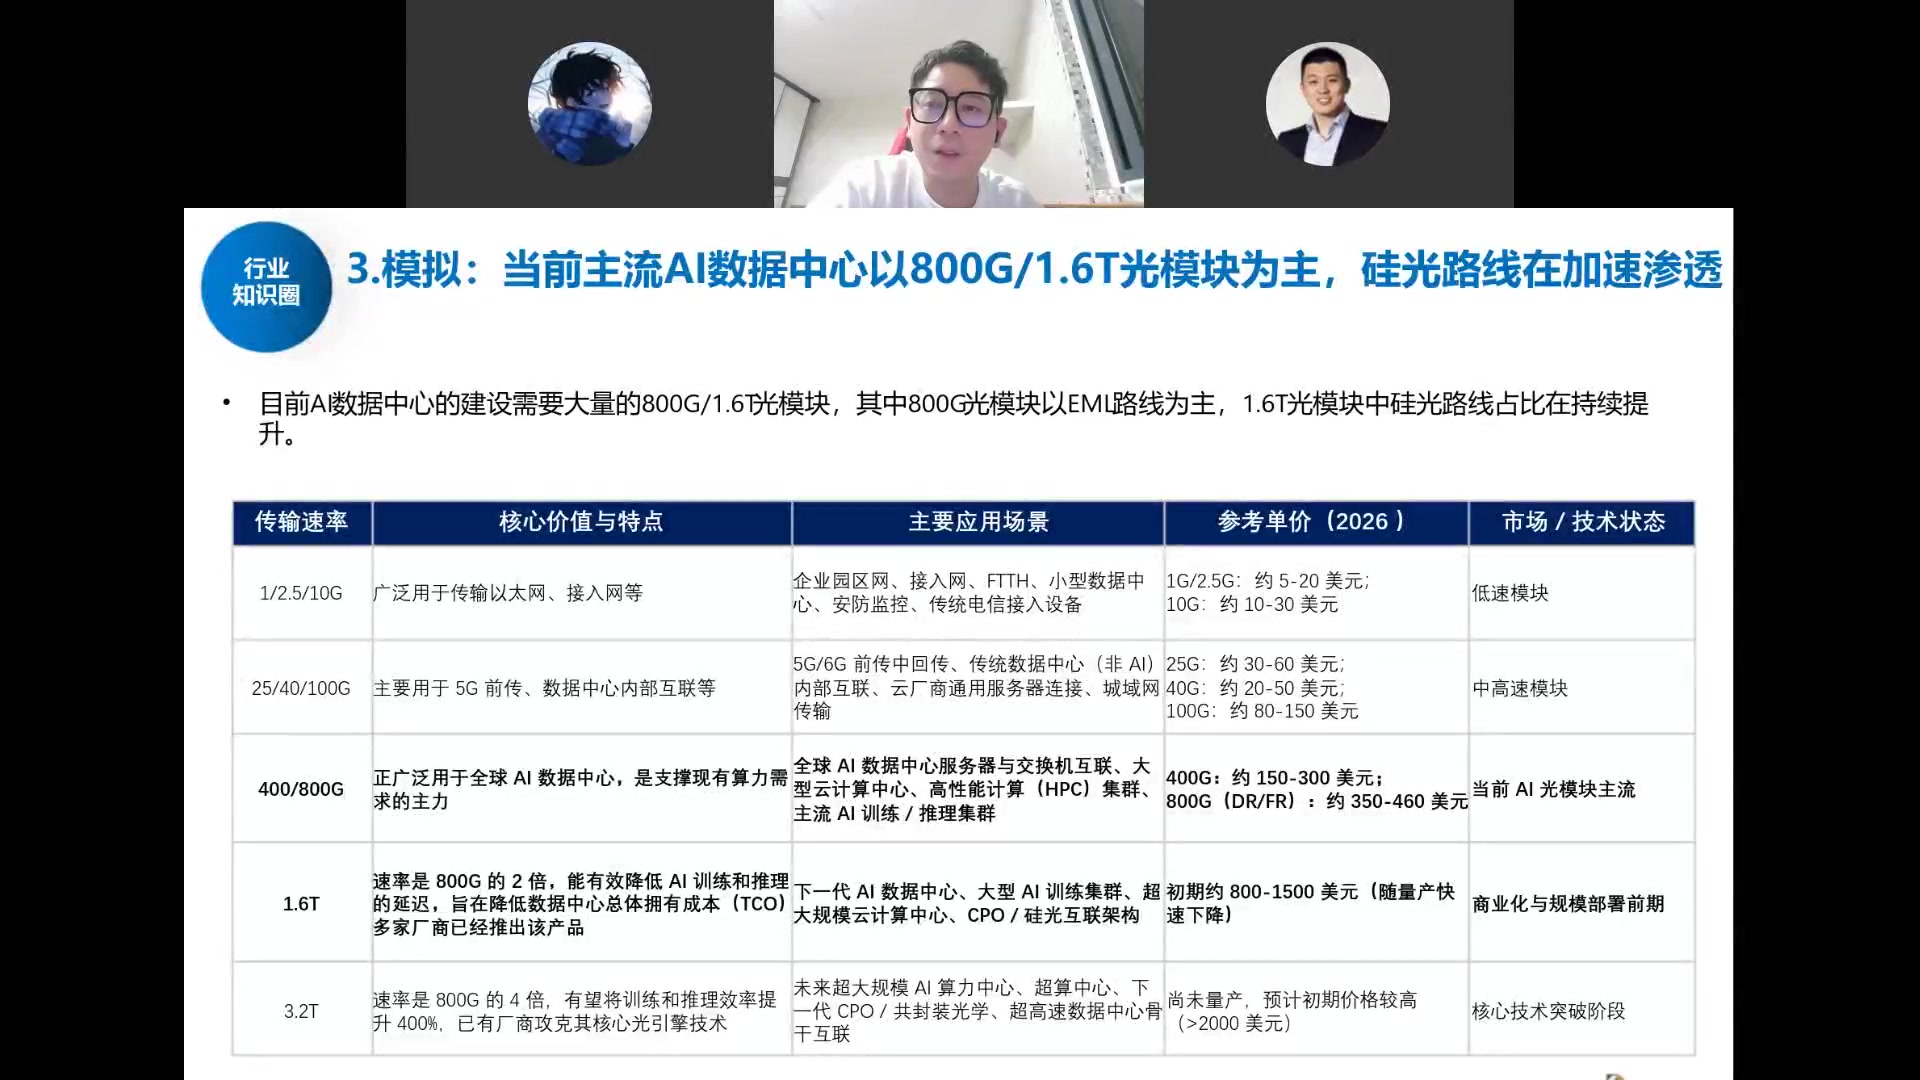
料号一:光模块里的模拟芯片。当前 AI 数据中心以 800G/1.6T 光模块为主,800G 以 EML 路线为主、1.6T 硅光占比持续提升。速率代际:400/800G 是当前主流(800G DR/FR 单条约 $350–460),1.6T 处于商业化规模部署前期(初期约 $800–1500 随量产快速下降),3.2T 仍在核心技术突破阶段(未量产、初价 >$2000)。
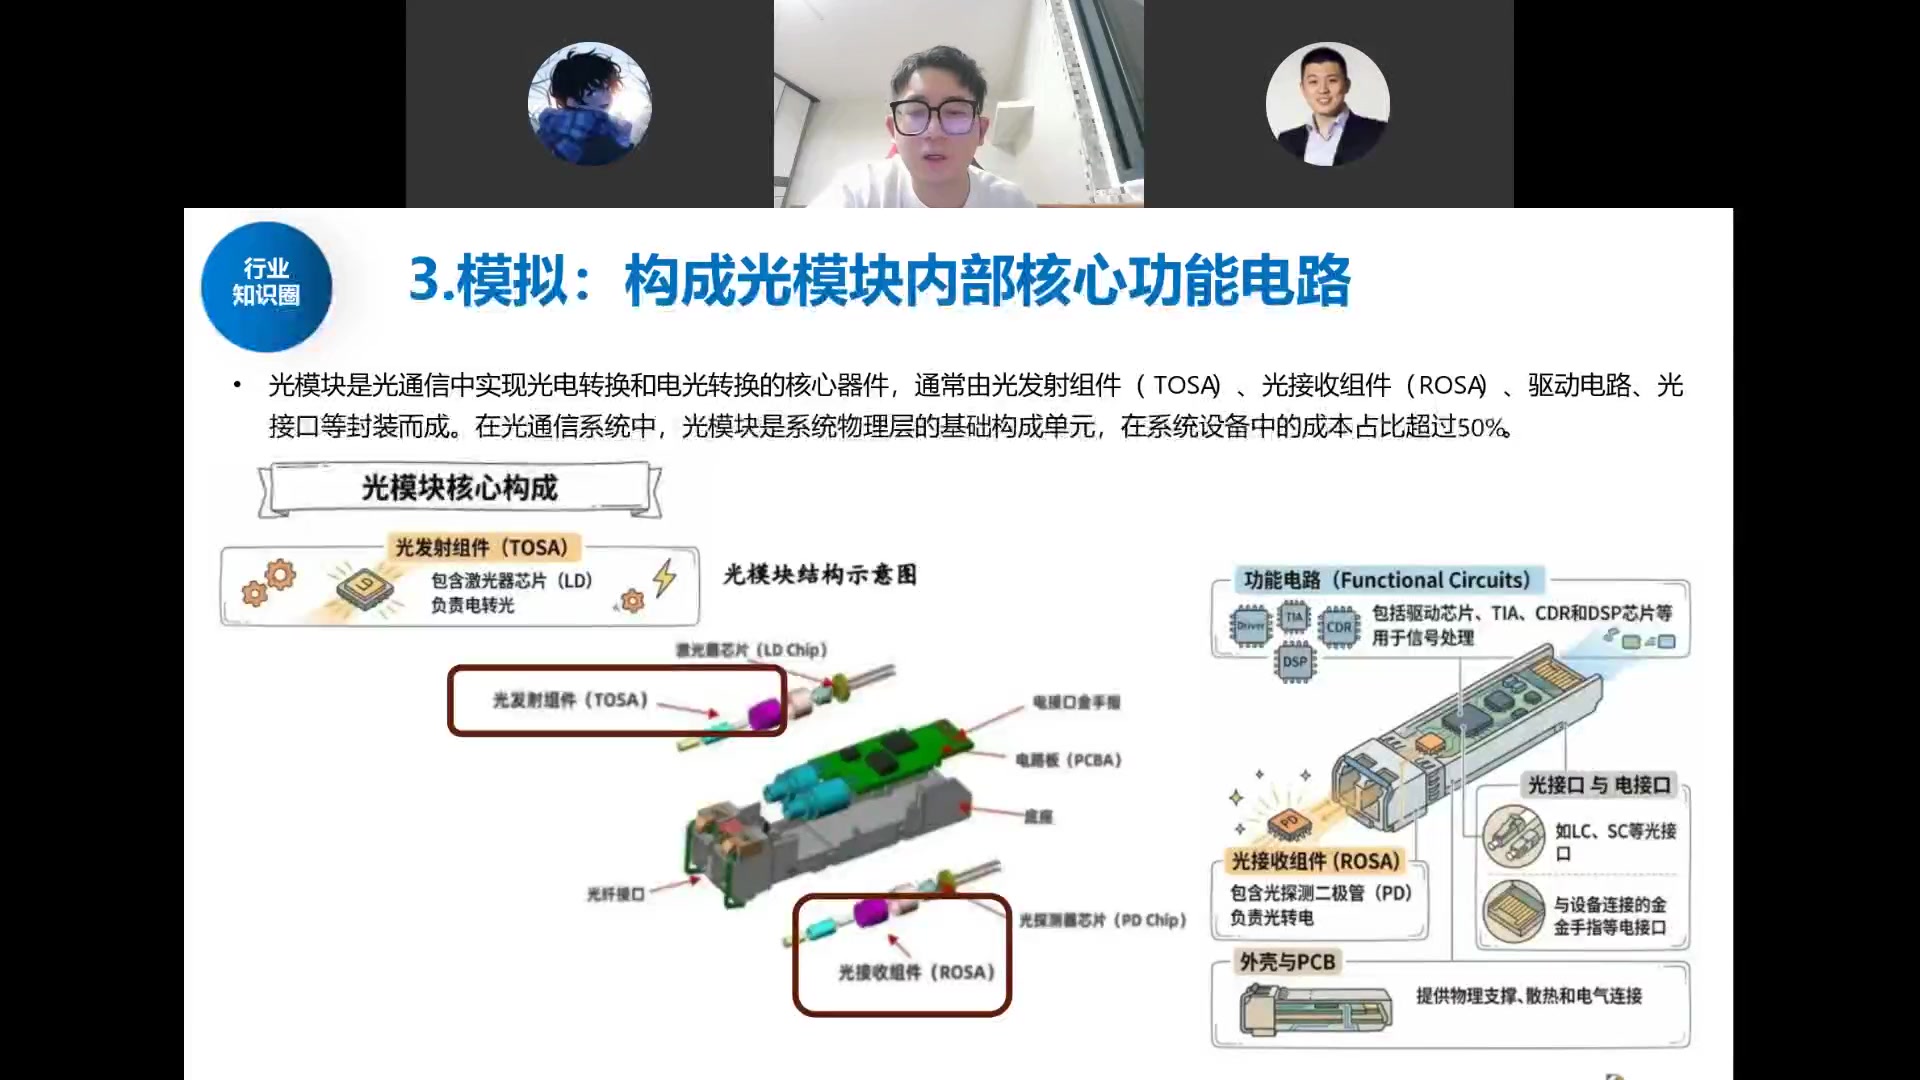
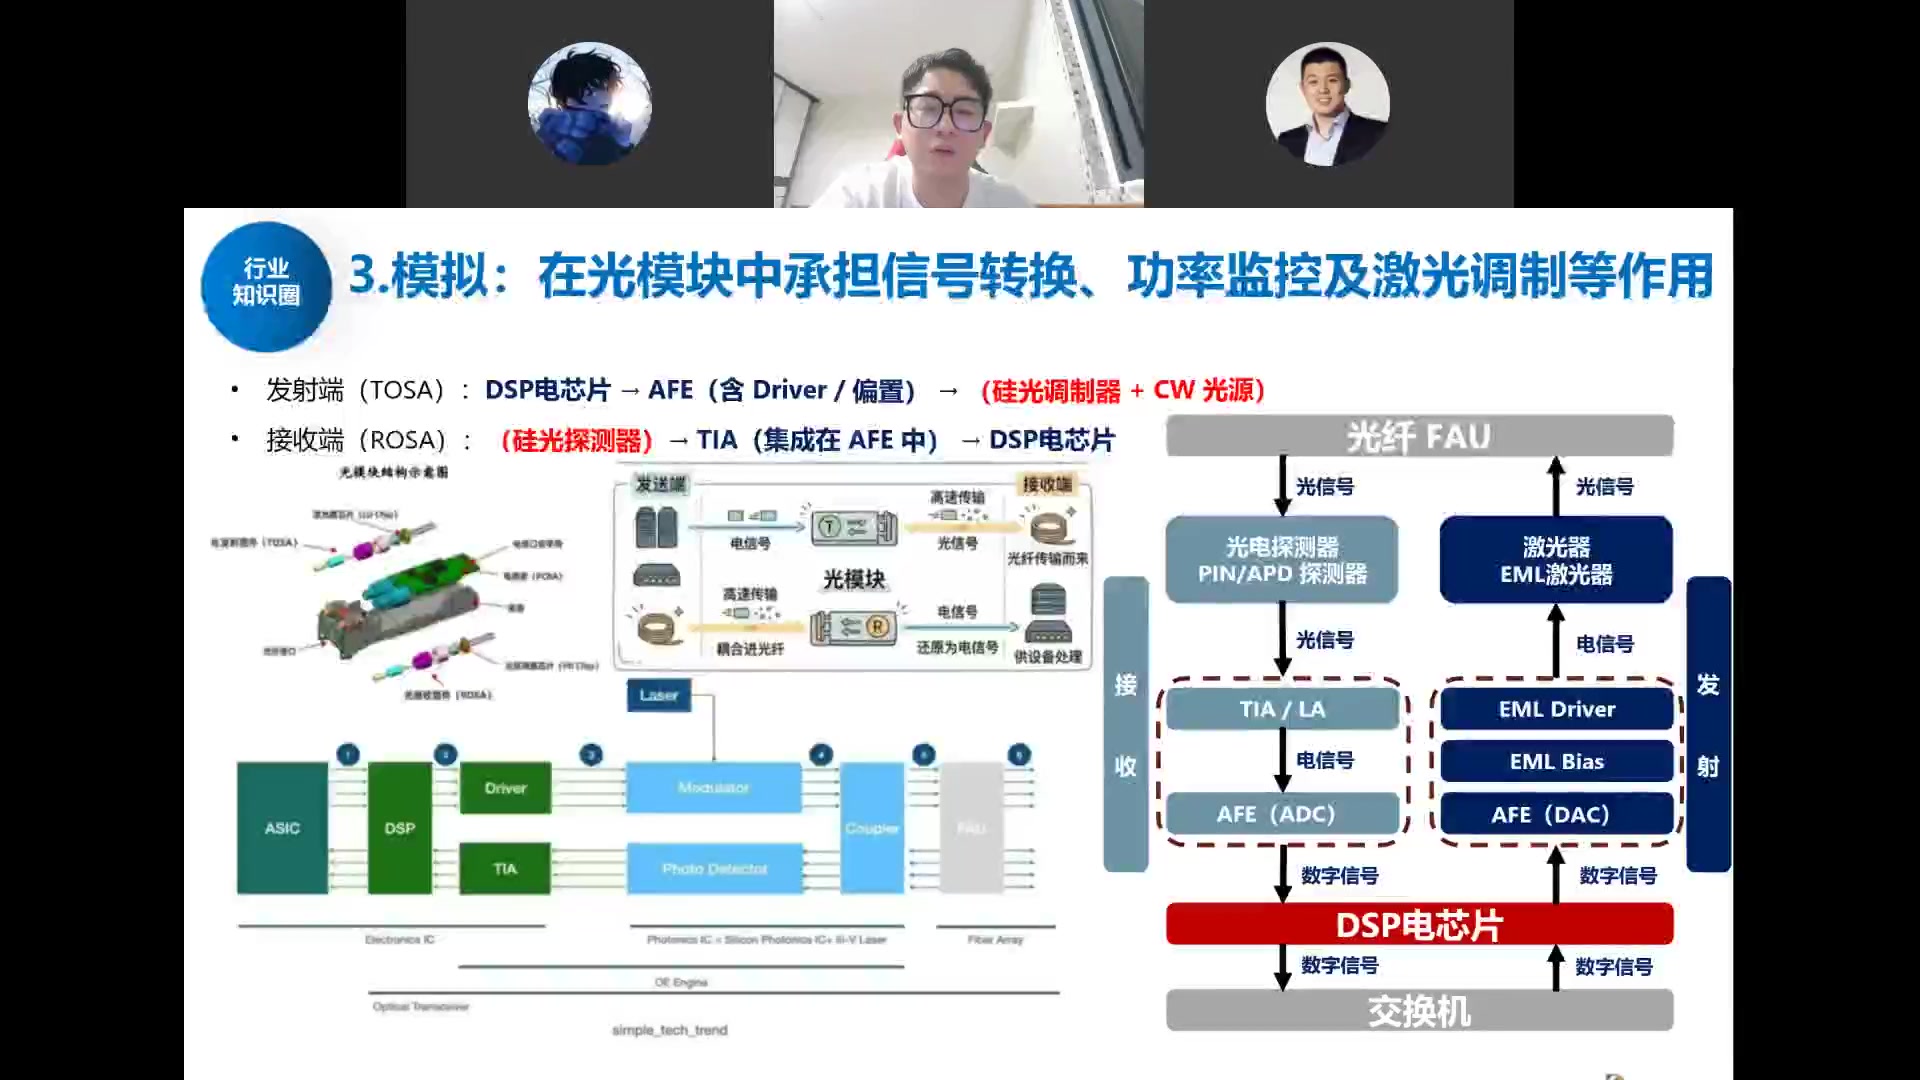
- 光模块构成:光模块是光通信中光电/电光转换核心器件,由光发射组件(TOSA,含激光器芯片 LD 负责电转光)、光接收组件(ROSA,含光探测二极管 PD 负责光转电)、驱动/TIA/CDR/DSP 等功能电路、光接口(LC/SC)与外壳 PCB 封装而成,在系统设备中成本占比超 50%。
- 信号链路:发射端 TOSA = DSP 电芯片 → AFE(含 Driver/偏置)→ 硅光调制器 + CW 光源;接收端 ROSA = 硅光探测器(PIN/APD)→ TIA/LA → AFE(ADC) → DSP 电芯片。难点在光转电的 TIA 和 DSP,真正放量的国产还没有,替代空间大。过去用德州仪器/ADI,因贸易供给不稳,光模块厂开始切国产。一个 800G 光模块里模拟芯片价值量约 50–100 元,国内市场约 100 亿(不含 DSP)。
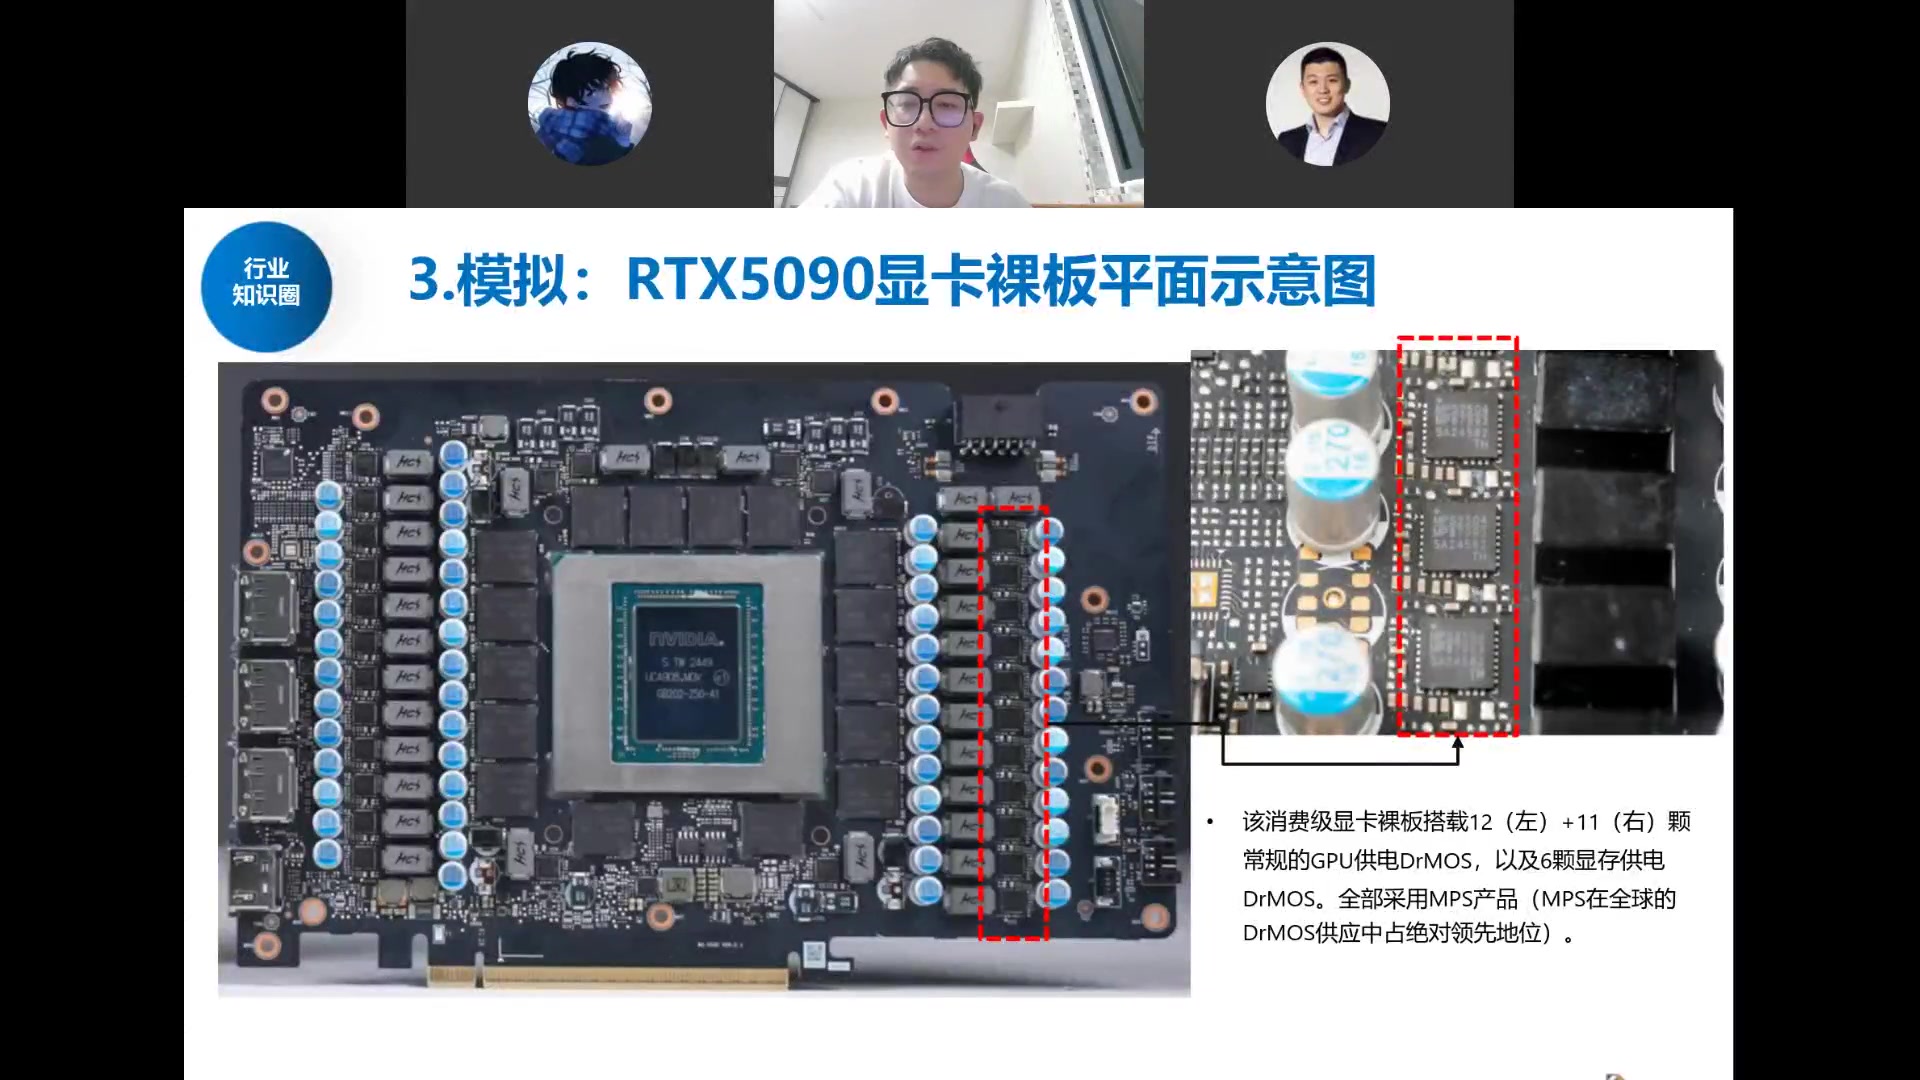
- 料号二:DrMOS(驱动+功率 MOS)。服务器三级电源(220V→48V→12V→GPU 侧约 1V)的关键器件。以 RTX5090 消费级显卡为例,裸板左右各搭 12+11 颗 GPU 供电 DrMOS 外加 6 颗显存供电 DrMOS,全部采用 MPS 产品(MPS 在全球 DrMOS 供应中占绝对领先)。
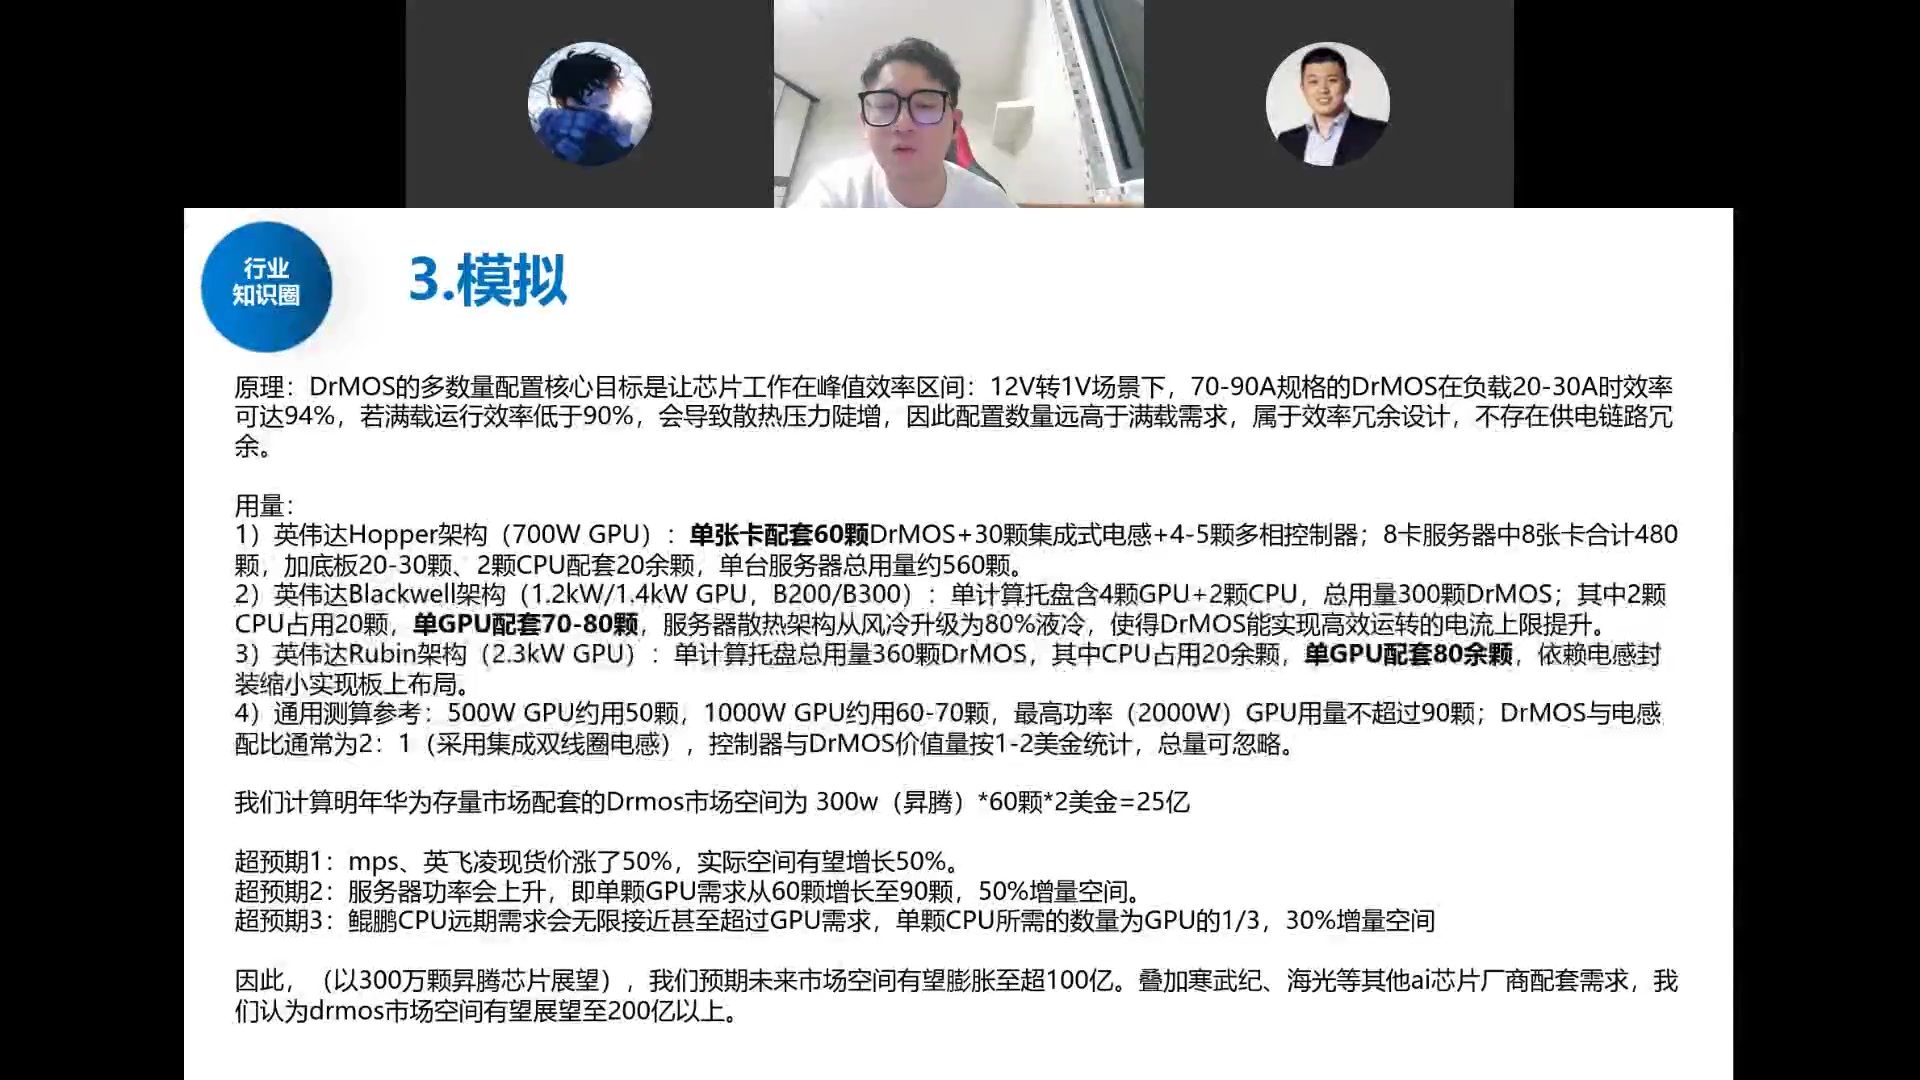
- 用量测算:英伟达 Hopper(700W GPU)单卡配约 60 颗 DrMOS+30 颗集成电感+4–5 颗多相控制器,8 卡服务器合计约 560 颗;Blackwell(1.2/1.4kW)单托盘 4GPU+2CPU 共约 300 颗(单 GPU 70–80、CPU 占 20);Rubin(2.3kW)单托盘约 360 颗(单 GPU 80 余、CPU 20 余)。通用参考:500W GPU 约 50 颗、1000W 约 60–70 颗、2000W 不超 90 颗。仅按华为昇腾 300w 颗×60 颗×$2 测算市场约 25 亿;考虑现货涨价 50%、单颗用量从 60 增至 90、CPU 需求追赶 GPU,叠加寒武纪/海光等,DrMOS 市场有望从 25 亿膨胀至 100 亿、远期 200 亿以上。海外明年起断供华为,份额瞬间给国内绑定深的厂商。
功率半导体
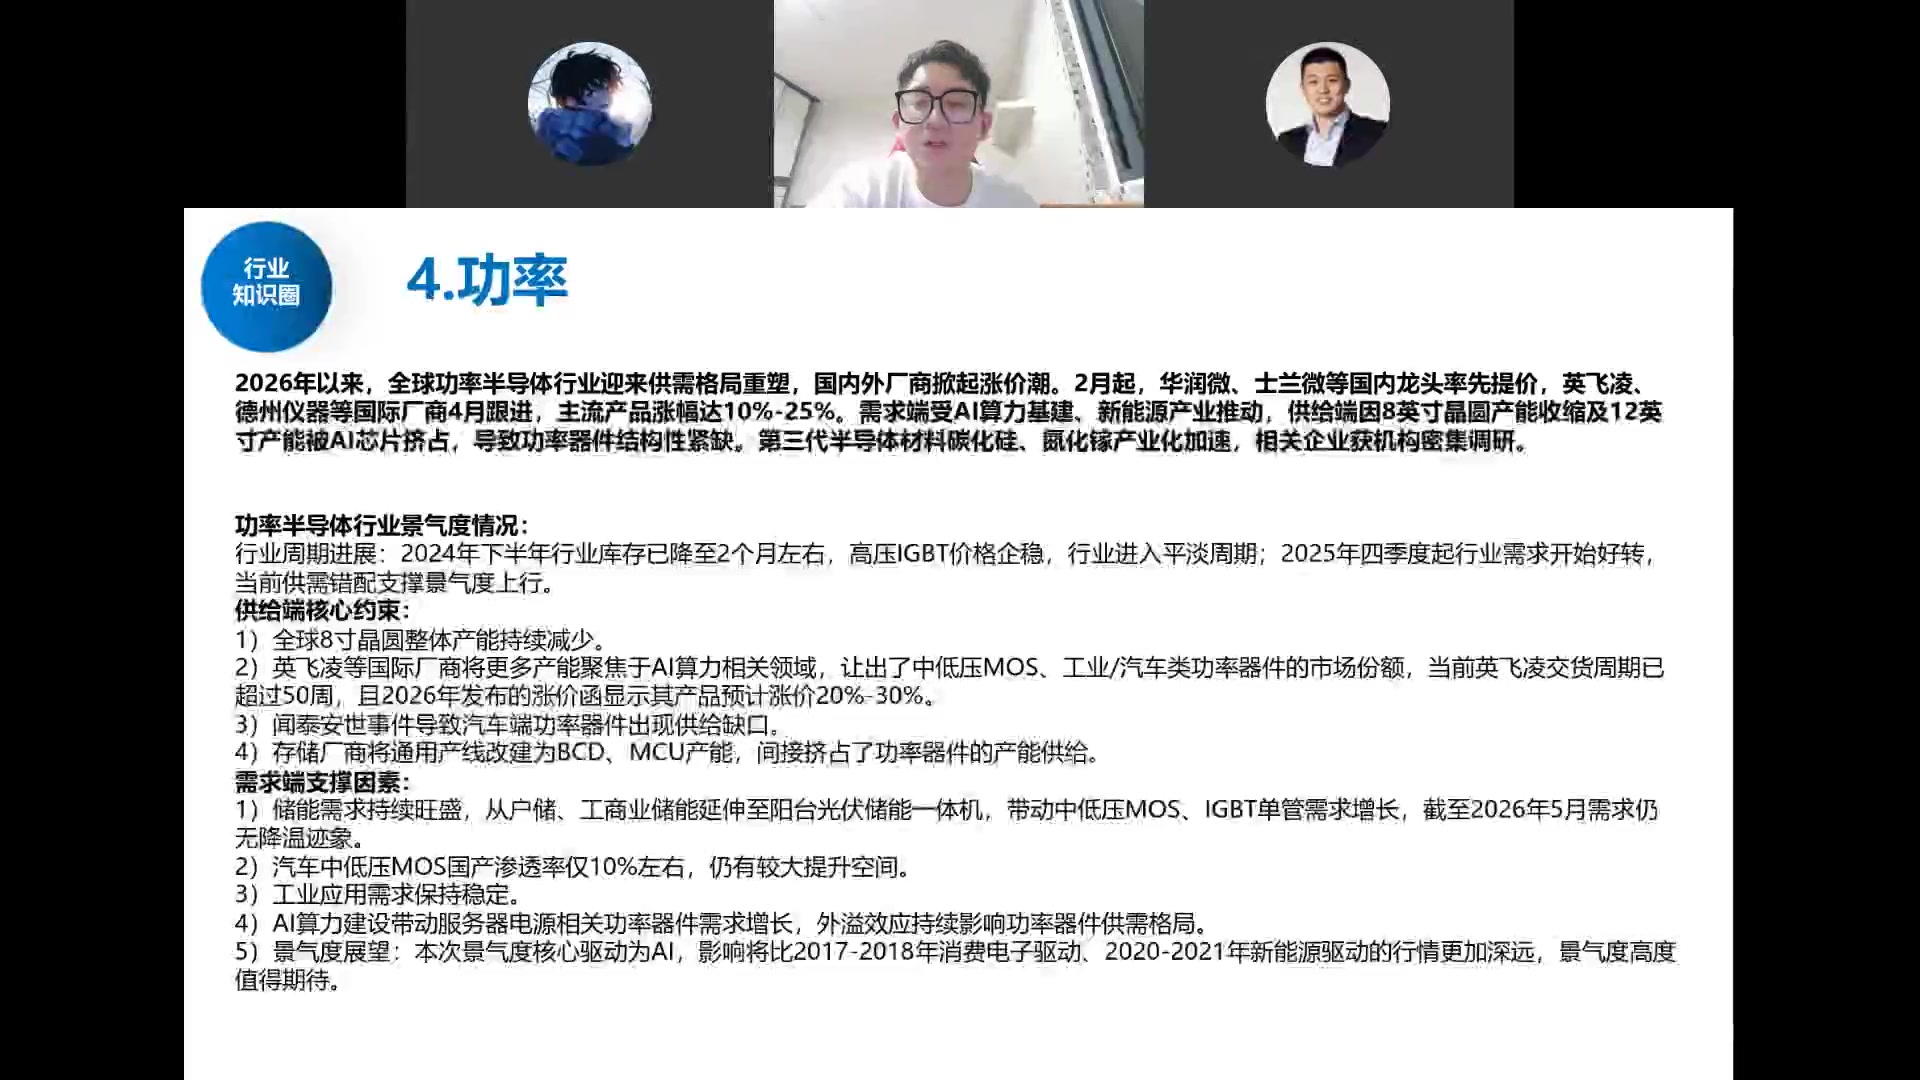
2026 年以来全球功率半导体供需格局重塑:2 月起华润微、士兰微等国内龙头率先提价,英飞凌、德州仪器 4 月跟进,主流产品涨 10%–25%,中低压 MOS 已涨 20%–30%。库存已降至约 2 个月、高压 IGBT 价格企稳;供给端 8 寸产能持续收缩、英飞凌聚焦 AI 算力让出中低压 MOS 份额(交货周期超 50 周、涨价函预计再涨 20%–30%)、闻泰被 ST 留下汽车功率缺口、存储厂转产 BCD/MCU 挤占功率产能;需求侧储能爆量(户储/工商业储能/阳台光储一体机)、汽车中低压 MOS 国产渗透率仅约 10%、AI 服务器带动外溢。
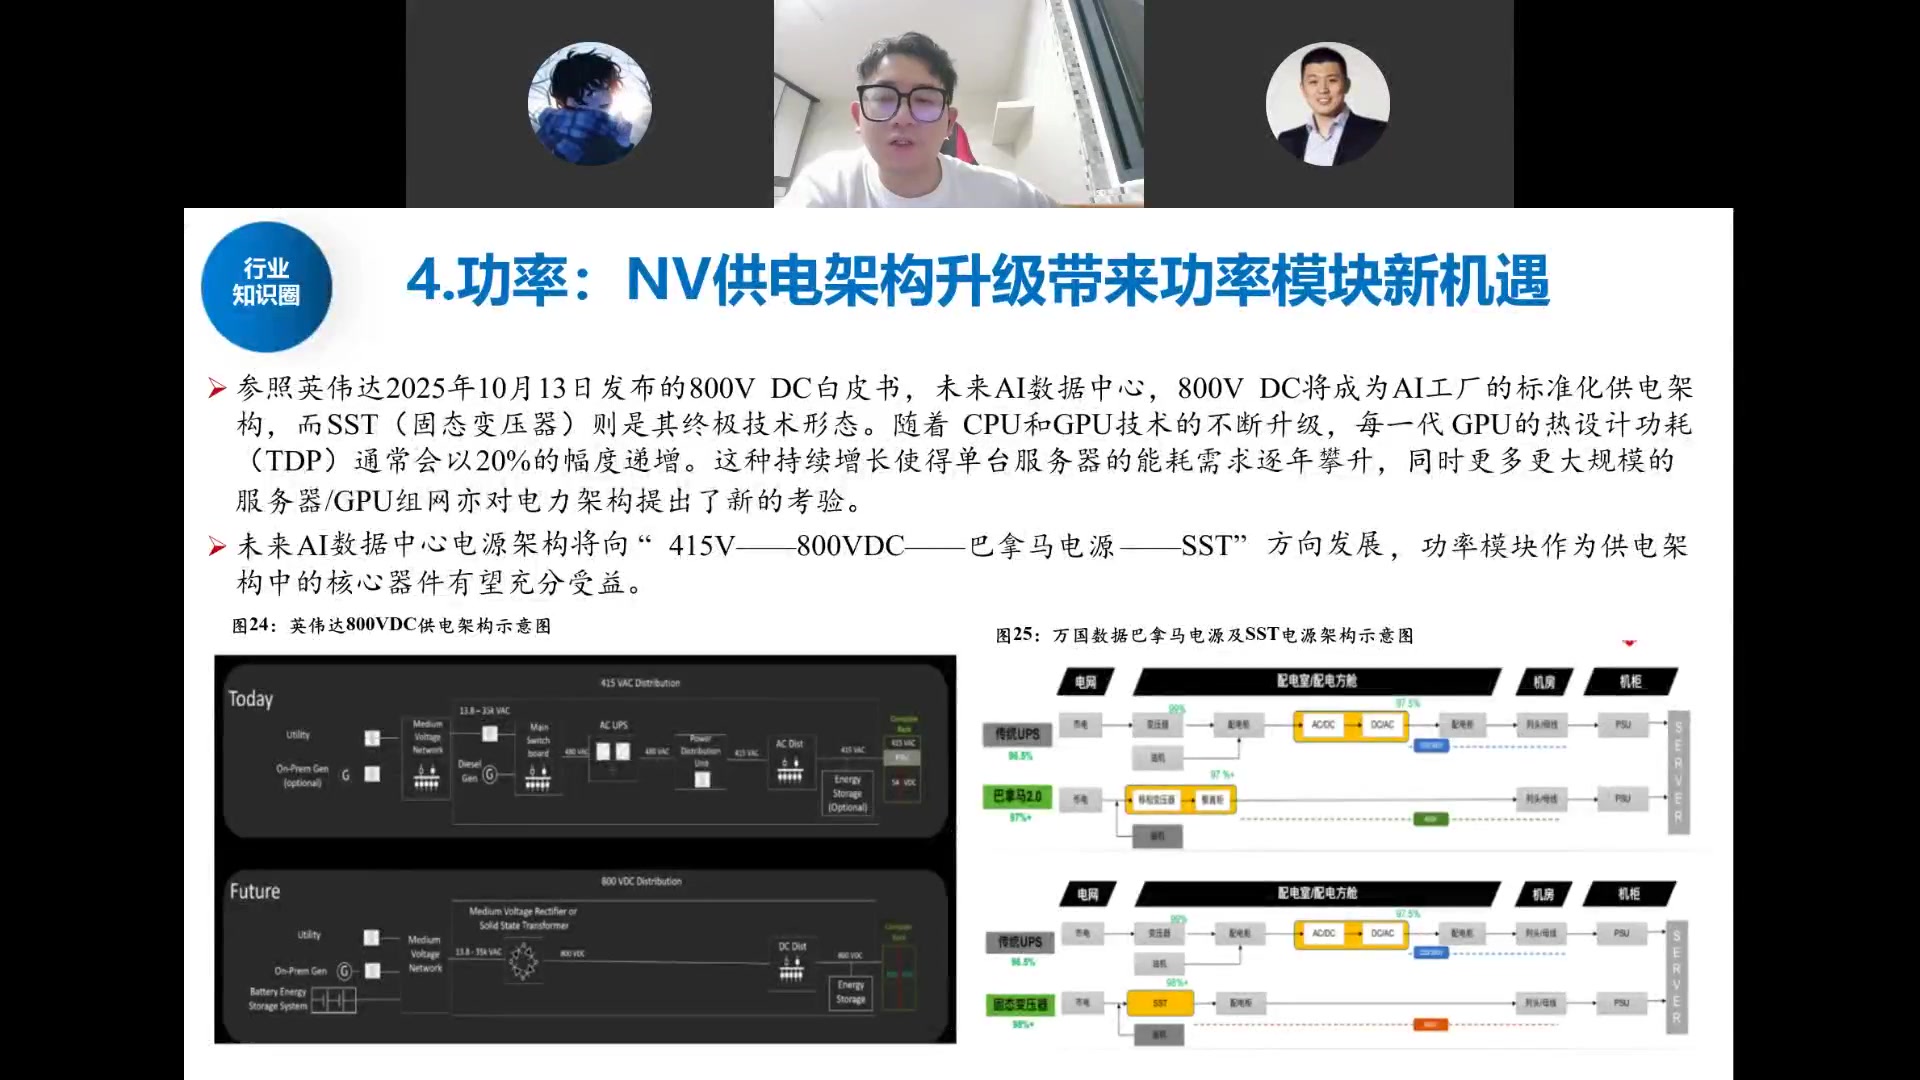
供电架构升级:参照英伟达 2025 年 10 月 800V DC 白皮书,未来 AI 数据中心从 415V AC 向 800V DC 标准化供电演进,终局为 SST(智能固态变压器)。电压从 415V 升到 800V 以在功率上升时保持电流不变、降低线损;SST 终局直接把市电 13.8kV 降到 GPU 侧约 1V,带动碳化硅需求(2030 年约 2000 万片、约 160 亿利润增量、支撑约 2000 亿市值增量)。
分销公司
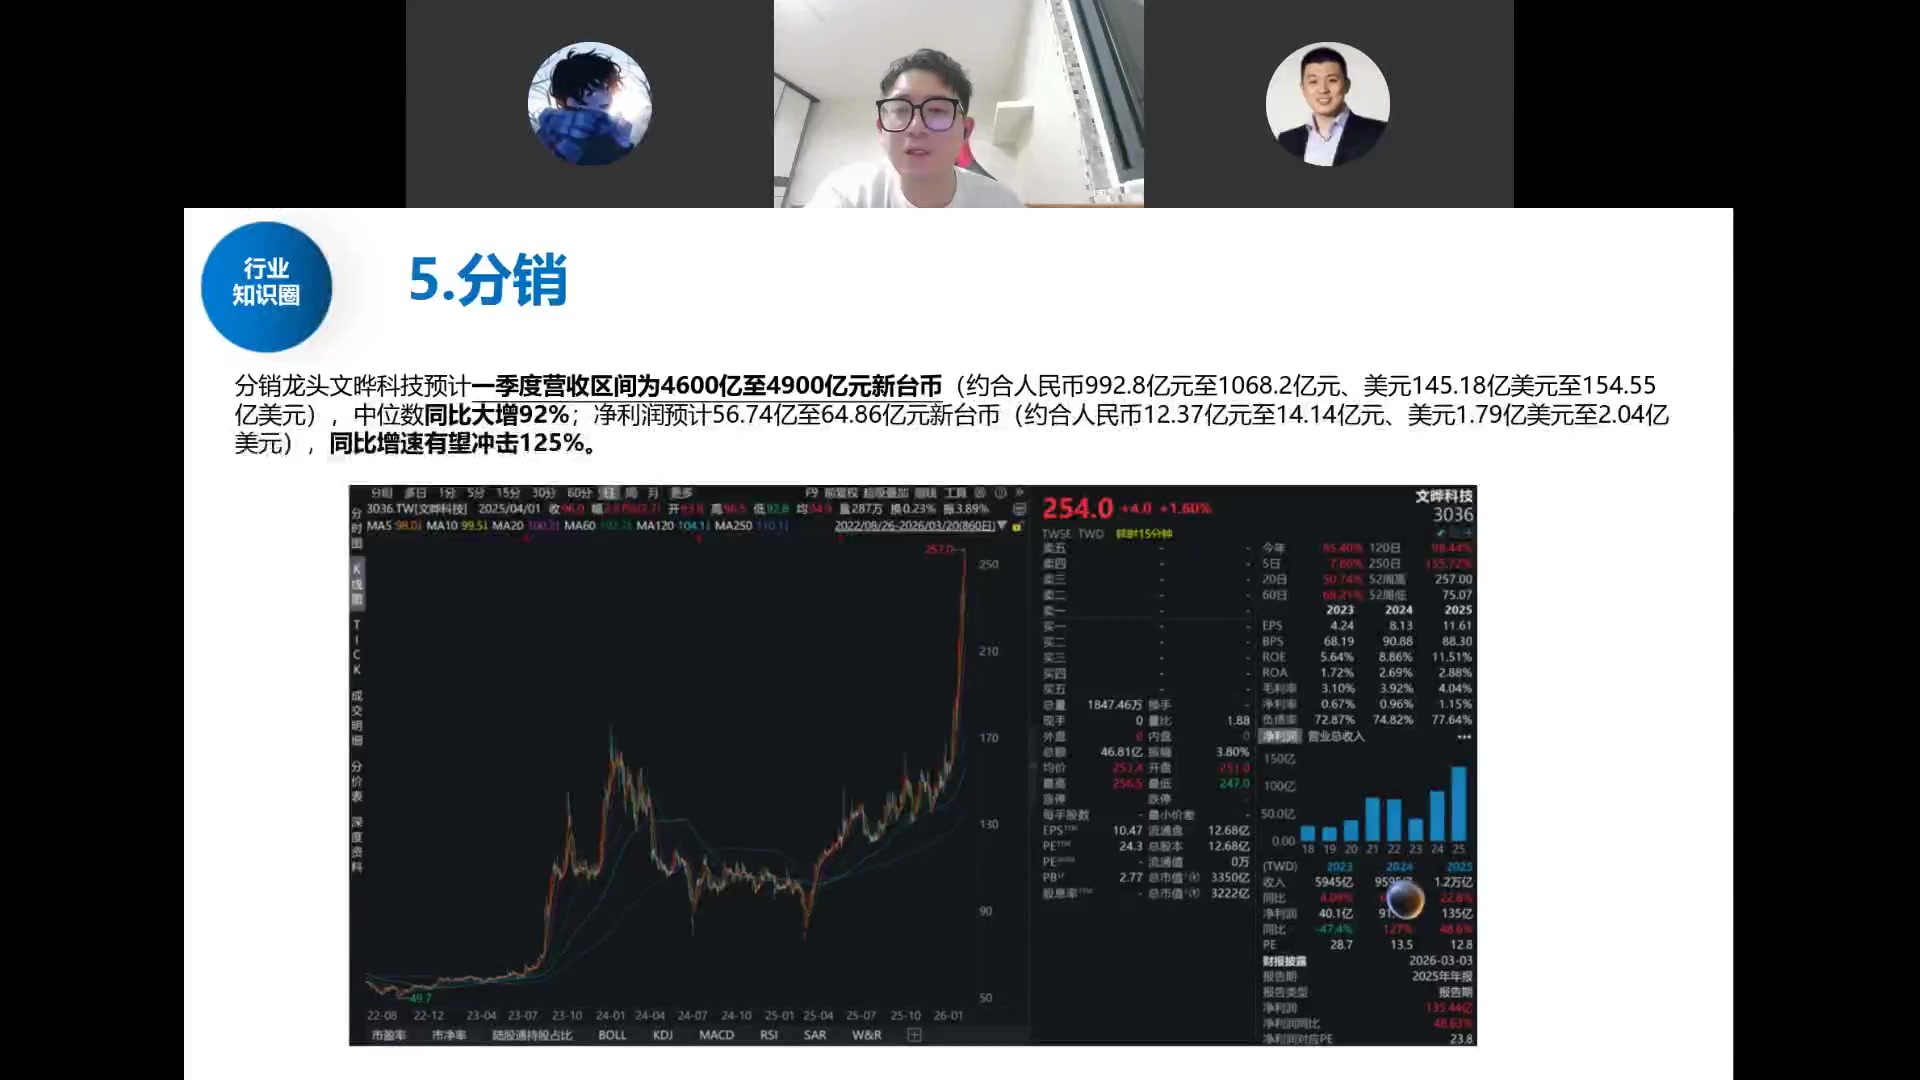
海外分销股竖涨。分销龙头文晔科技预计一季度营收 4600–4900 亿新台币(约 992.8–1068.2 亿人民币),中位数同比大增 92%;净利润 56.74–64.86 亿新台币(约 12.37–14.14 亿人民币),同比增速有望冲击 125%。
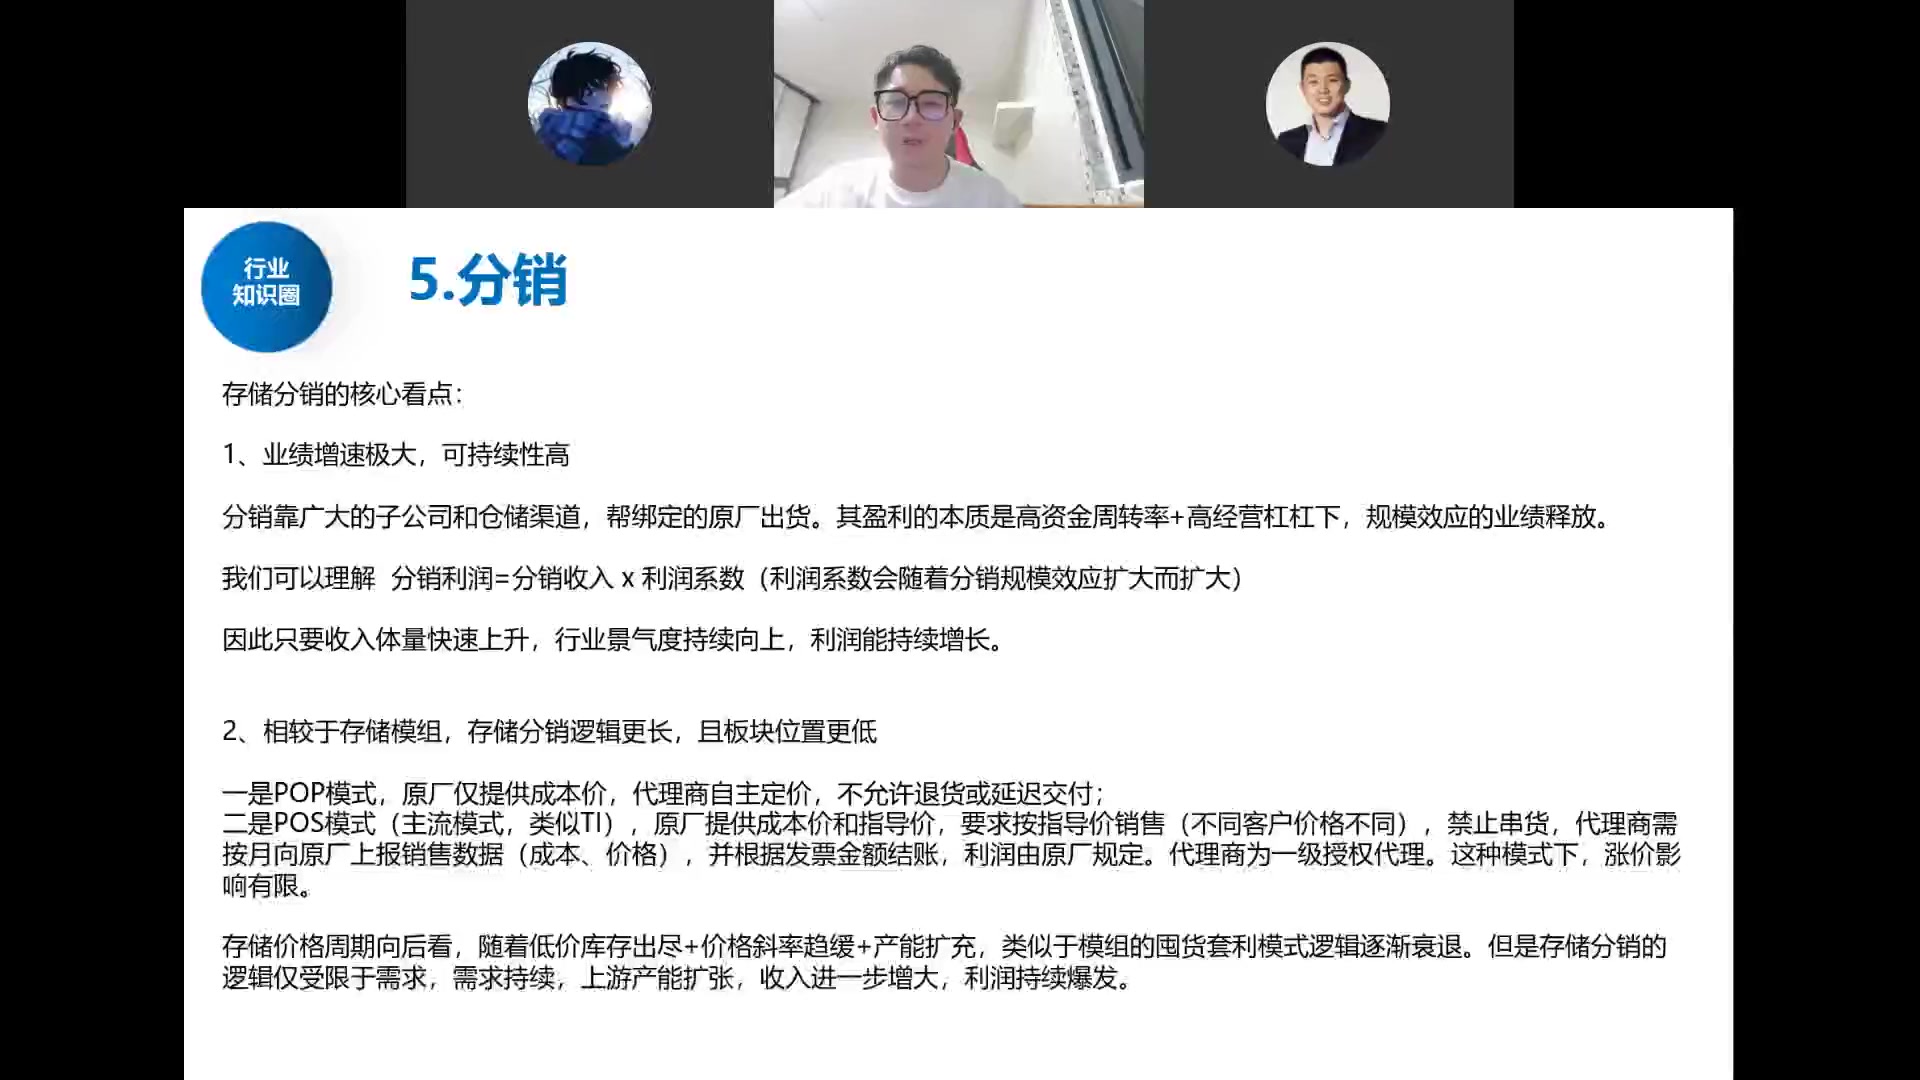
分销逻辑是"傍原厂规模"而非囤货涨价:分销利润 = 分销收入 × 利润系数(规模效应下系数随营收扩大而扩大),只要原厂(长鑫长存、村田 MLCC 等)收入扩大,分销商业绩同步放大。相较存储模组厂的低价囤货-涨价卖出逻辑,分销分 POP 模式(原厂成本价、代理商自主定价不退换)与 POS 模式(主流类 TI,按指导价销售、禁止串货、按月上报);存储价格周期后段模组囤货逻辑衰退,但分销仅受限于需求——需求持续、上游扩产,收入与利润持续爆发。位置和估值都便宜,是景气度β的低估值配置。
六、后市判断:没有跑到头的细分
被问到"哪个细分已经跑到头/证伪",研究员的回答是:没有任何一个细分跑到头,也没有出现证伪逻辑。
- 为什么没走完:① 新逻辑不断涌现——韬定律让国内先进制程可对标台积电给估值,还新增加一笔设备/键合扩产需求;② 涨价才刚开始——现在涨的是过去最惨的环节(功率),AI 相关涨价刚起头,硅片、化学品材料等还没轮到,是多米诺骨牌。
- 节奏特点:半导体空间足但向下估值边界低,一旦涨快了就要调一段时间才出第二波(如寒武纪调了一年);行业内部喜欢"高切低"——设备涨完涨晶圆厂、再拉低位板块,脉冲式上涨但拉长线都涨。
- 最看好方向:晶圆厂(同时代表先进制程工艺与成熟制程景气,两长上市后市值差距会带动整个行业估值重估)、成熟制程里最先放利润的公司、以及两长扩产链。
一句话总结:韬定律解决"做不出先进制程"的问题,成熟制程涨价解决"赚不到钱"的问题;AI 远未走完,半导体各细分脉冲式轮动,但拉长线都向上。